ARTICLE
Agenstro 开发记录(三):几个简单的示例
以卓里奇题解、Bourbaki PDF 转 LaTeX 和 nnhr 字幕制作为例,复盘 Agenstro 在长程工作流中的任务拆分、校验、恢复与人工反馈。
文章目录
笔者早期的项目是一系列python sdk,后来逐步转型到haskell+rust的方案上。 也正是这个原因,早期的不少测试项目已经遗失了,他们有惨不忍睹的运行时错误,包括但不限于各种超时、变成孤儿线程、工作区快照失效等等。
因此这里放的几个,是项目已经确立好基础之后完成的内容。
以下我都会按照一个固定的顺序展开,分写动机与目的、问题与改进、最终形态。重点看看实际的 Tactus 脚本怎样拆任务、怎样写 prompt,以及模型给出答案之后,程序还需要做什么。
文中的 prompt 是对脚本内容的压缩转述。
第一个案例,自动刷题机器人
最终结果:Tensorera/Zorich-7th-Edition-Exercises。
动机与目的
第一个案例是给《卓里奇数学分析》第七版的两卷习题生成中文解答。 把分散在教材里的习题整理成可以逐题查阅查阅、继续校对的题解集,借此测试haskell的并发是否足够问题。
这个项目的主体只有两个脚本。010_extract_exercises.hs 从已有的 OCR Markdown 中识别章、节和题号,建立“一道题一个文件”的目录;
020_solve_exercises.hs 再找出没有答案的题目,逐题调用模型。前一个脚本负责确定题目边界和保存路径,后一个负责生成解答。
注:这里 PDF → Markdown 采用了 MinerU API,一个非常 powerful 的项目。
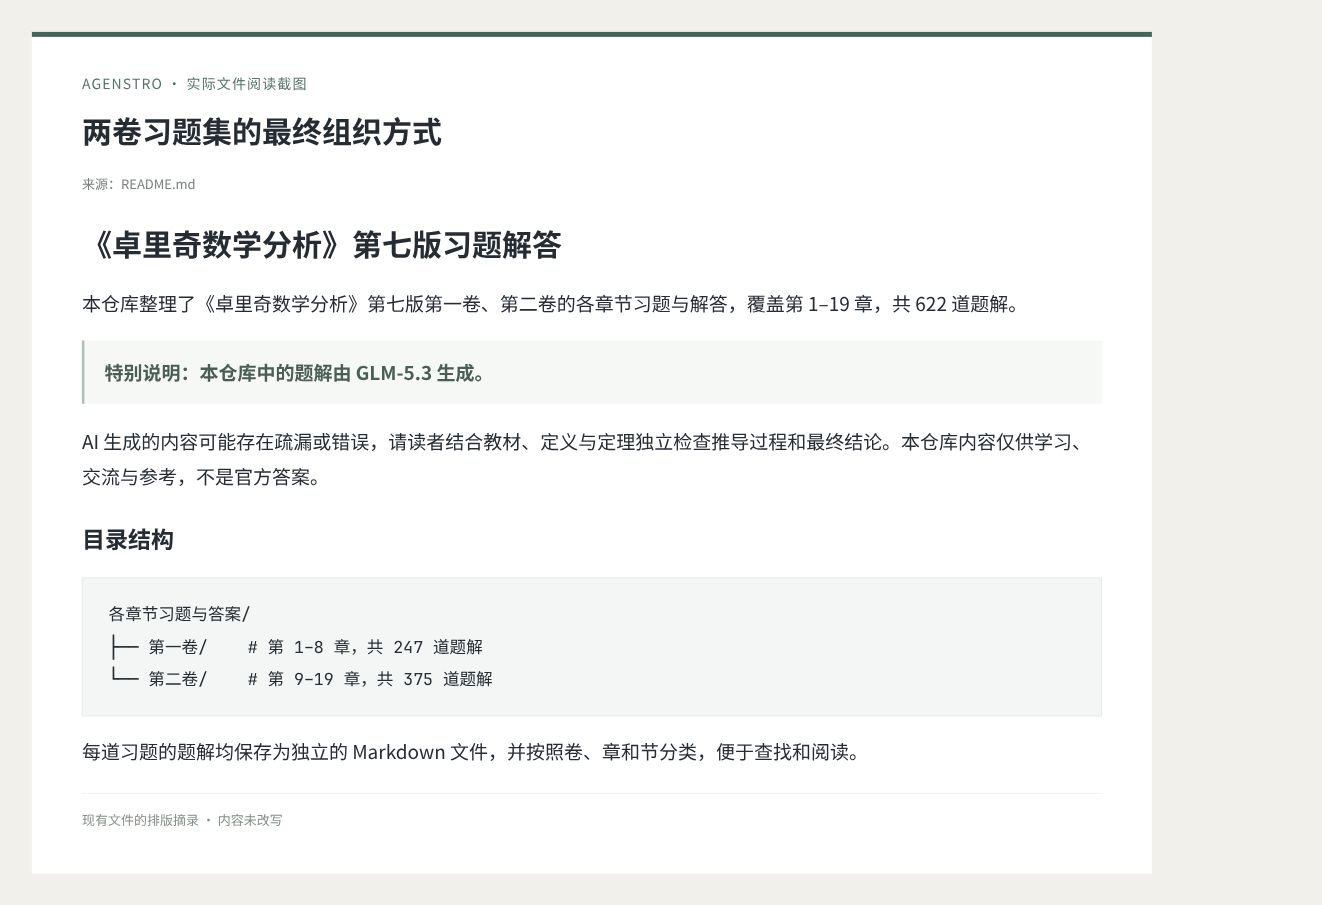
图 1:现有题解集按两卷组织,每题都是独立的 Markdown 文件。
抽题时还要保留原书插图、改写图片的相对路径,并检查题号是否重复。 重新抽取题目时,脚本会保留已经存在的答案,避免整理目录时把求解结果覆盖掉。
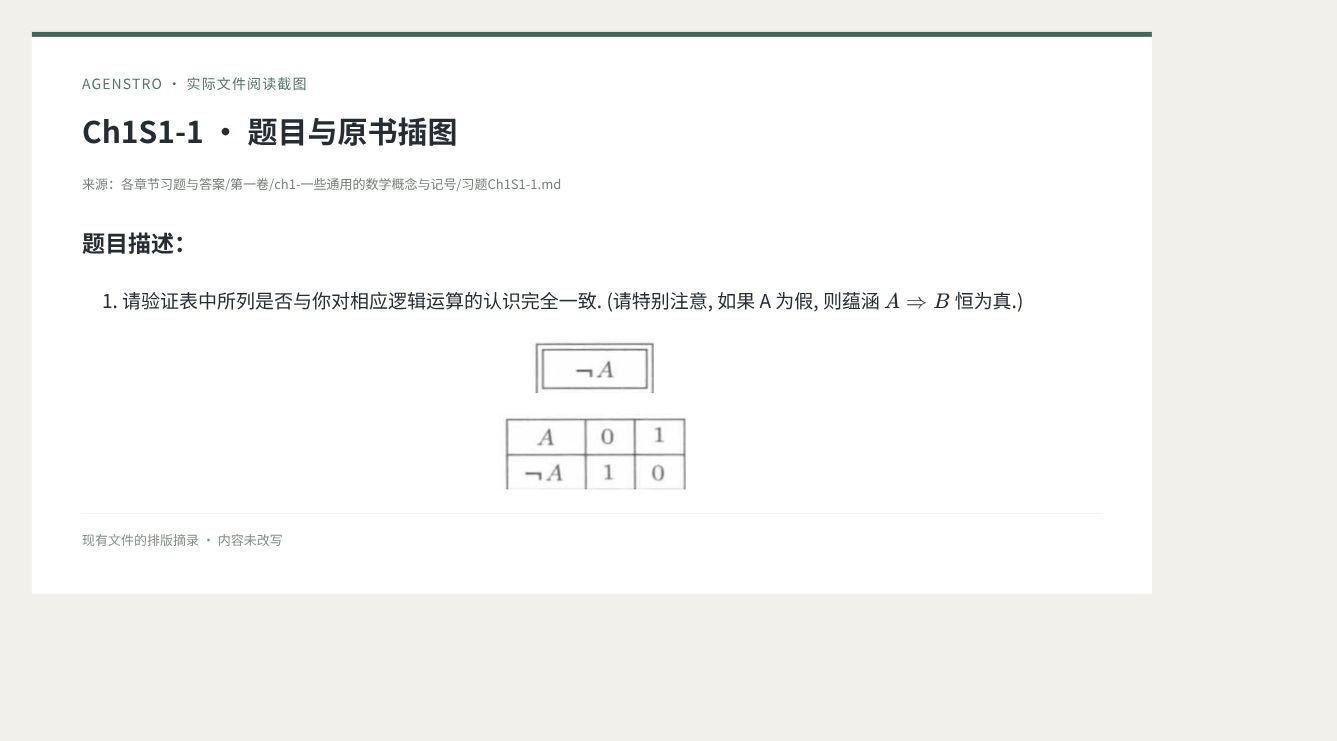
图 2:Ch1S1-1 的题干与部分原书插图。这样的题不能只给模型一段文字。
求解任务的定义很短:
solutionTask :: Task PromptInput Solution
solutionTask = task "solve-zorich-exercise" renderPrompt decodeSolution
PromptInput 带着当前习题及其教材上下文;
renderPrompt 把它们组织成请求,decodeSolution 检查回答并转换为 Solution。
实际调用使用 Claude Code provider,模型配置为 GLM-5.3、推理强度为 max。普通题关闭工具;
题目含图时,才允许读取相关图片。
问题与改进
我遇到的第一个问题是格式问题。笔者让gpt写solve_exercise.hs 结果他让glm直接输出json,然后把一整个文本块都塞到解答里面去,这导致整个解答文件完全不可读。
这主要是gpt的理解偏差,经过改进之后修复了这个问题。
第二个问题是题目并不总能独立理解。 “证明公式(16)”或“推广例 2”这样的要求,离开教材就缺少条件。 即使模型知道相关知识,也可能采用另一套定义或记号。
因此,prompt 除了题目,还带有该节的教材片段。 较短的节直接提供,较长的节截取开头与习题前的部分。 核心要求可以概括为:
解答这一道题,采用所附教材中的定义、公式编号和约定。 用中文写出完整推导,逐项回答所有小问。 只返回解答正文;小问标记清楚,独立公式用成对的
$。 不自行搜索工作区;有图时只读取题目引用的图片。
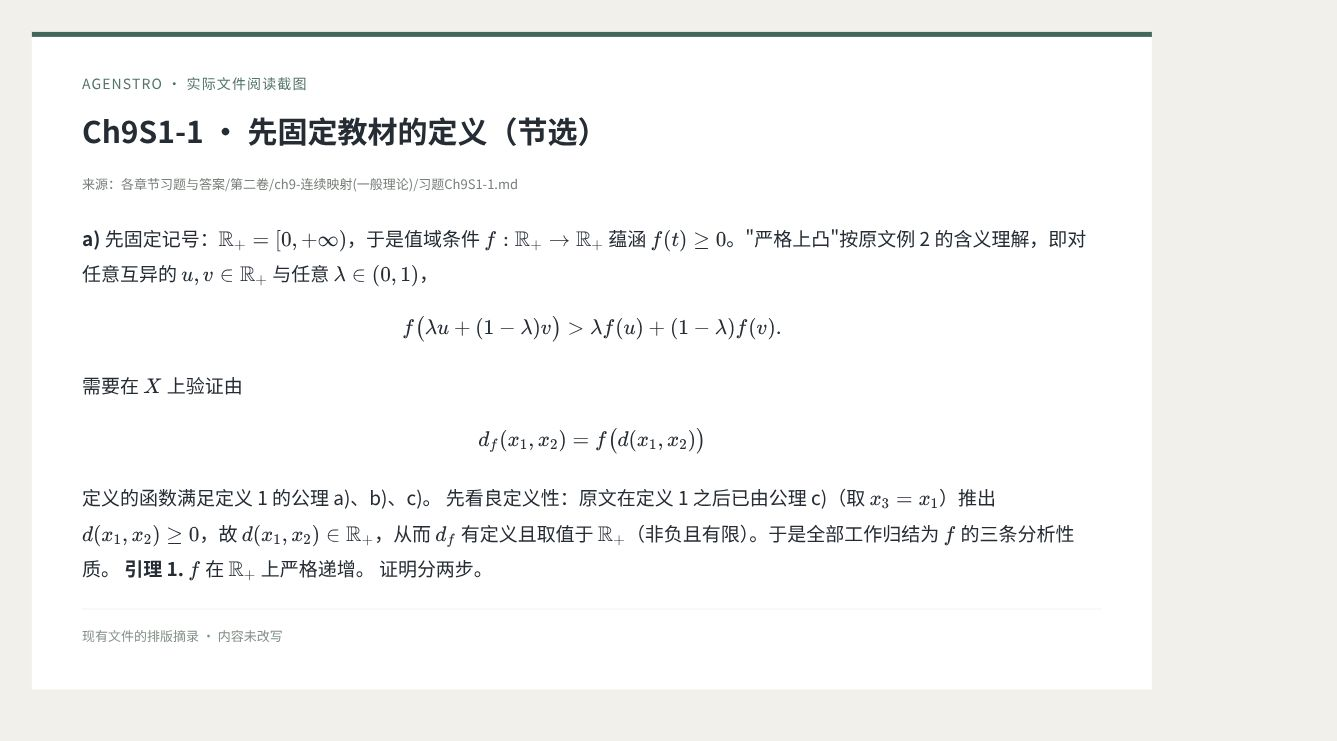
图 3:Ch9S1-1 先明确教材中“严格上凸”的含义,再验证新度量。上下文影响的是证明的起点。
第三个问题是长题容易被截断,或者只完成前几个小问。 当前脚本除了检查回答非空、包含中文、达到最低长度,还检查独立公式是否闭合,以及题干中可识别的小问标签是否全部出现在答案中。
这些检查只能发现明显的结构问题。 对于特别长的题,脚本进一步改变任务划分。例如 Ch18S3-1 被拆成四次调用,分别处理 a–c、d、e、f,最后组合为一份解答; 各次 prompt 都强调傅里叶变换的归一化和常数约定。
注:实际进行这个任务的时候codex一直在监视,充当一个守护进程(daemon)的作用。 就如同上面的长问题,即便设置glm的思考时间为1h,也会存在超时的风险。 codex 作为守护进程能够及时的处理这些异常,当然这里面笔者也查看过几次问题。
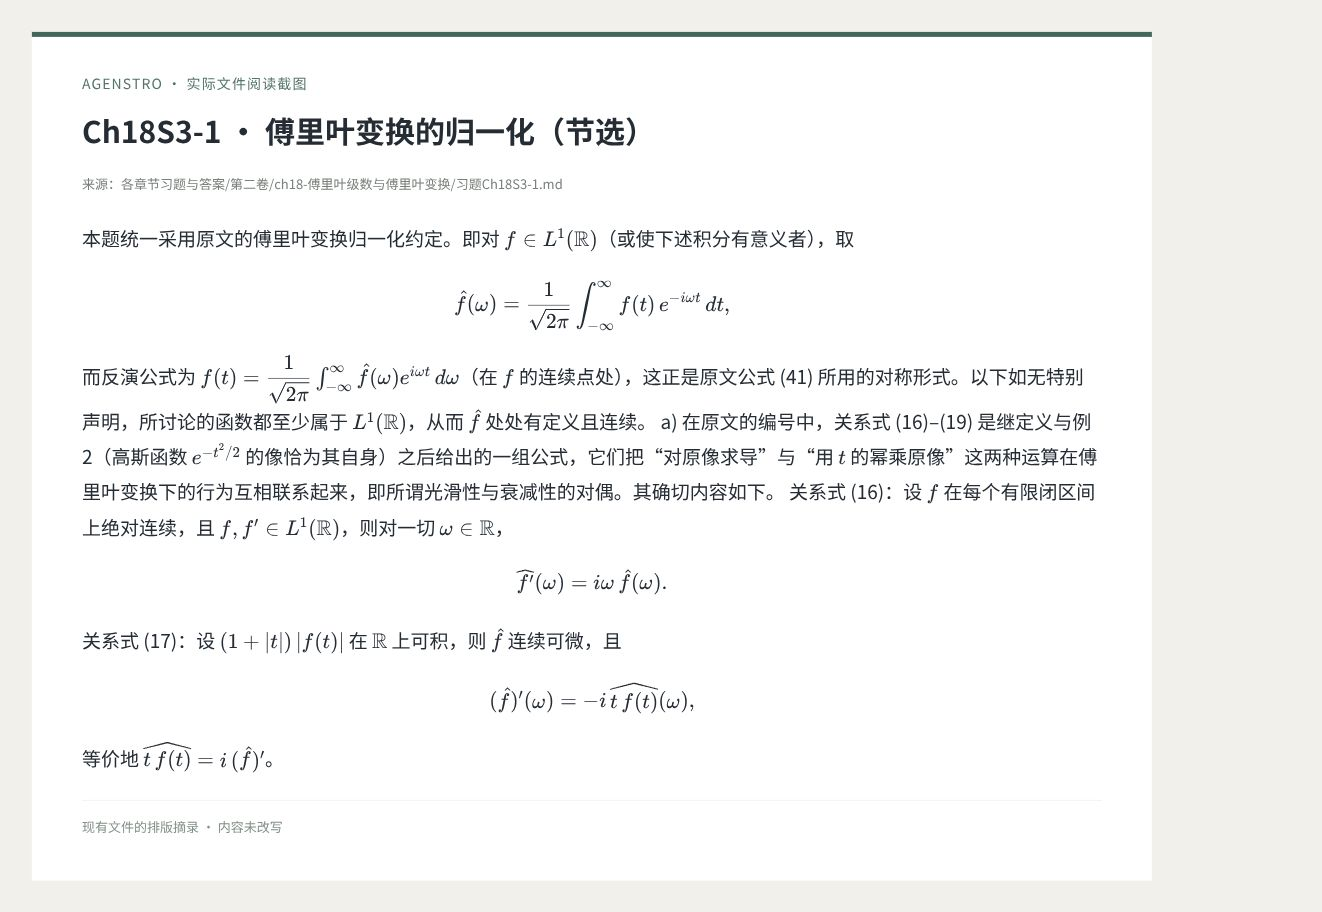
图 4:Ch18S3-1 的解答开头。拆分任务后,仍然需要固定共同的记号与归一化。
第三个问题是失败后怎样继续。 脚本把题目分到三条并行队列,每条队列内部顺序求解。 一题通过检查就立刻写回对应文件,下次运行跳过已有非空答案的题目,也可以指定题号单独处理。
这样,超时或某次回答无法解析时,已经完成的题解仍然留在目录里。 当前实现用“答案是否非空”判断是否需要重做,因此它记录的是生成进度,不能代替对已有答案的再次审阅。
最终形态
现有目录共有 622 份带非空解答的 Markdown 文件,第一卷 247 份,第二卷 375 份,覆盖第 1–19 章。 产物既有简单的逻辑表格,也有连续性、微分和渐近展开的长篇推导。
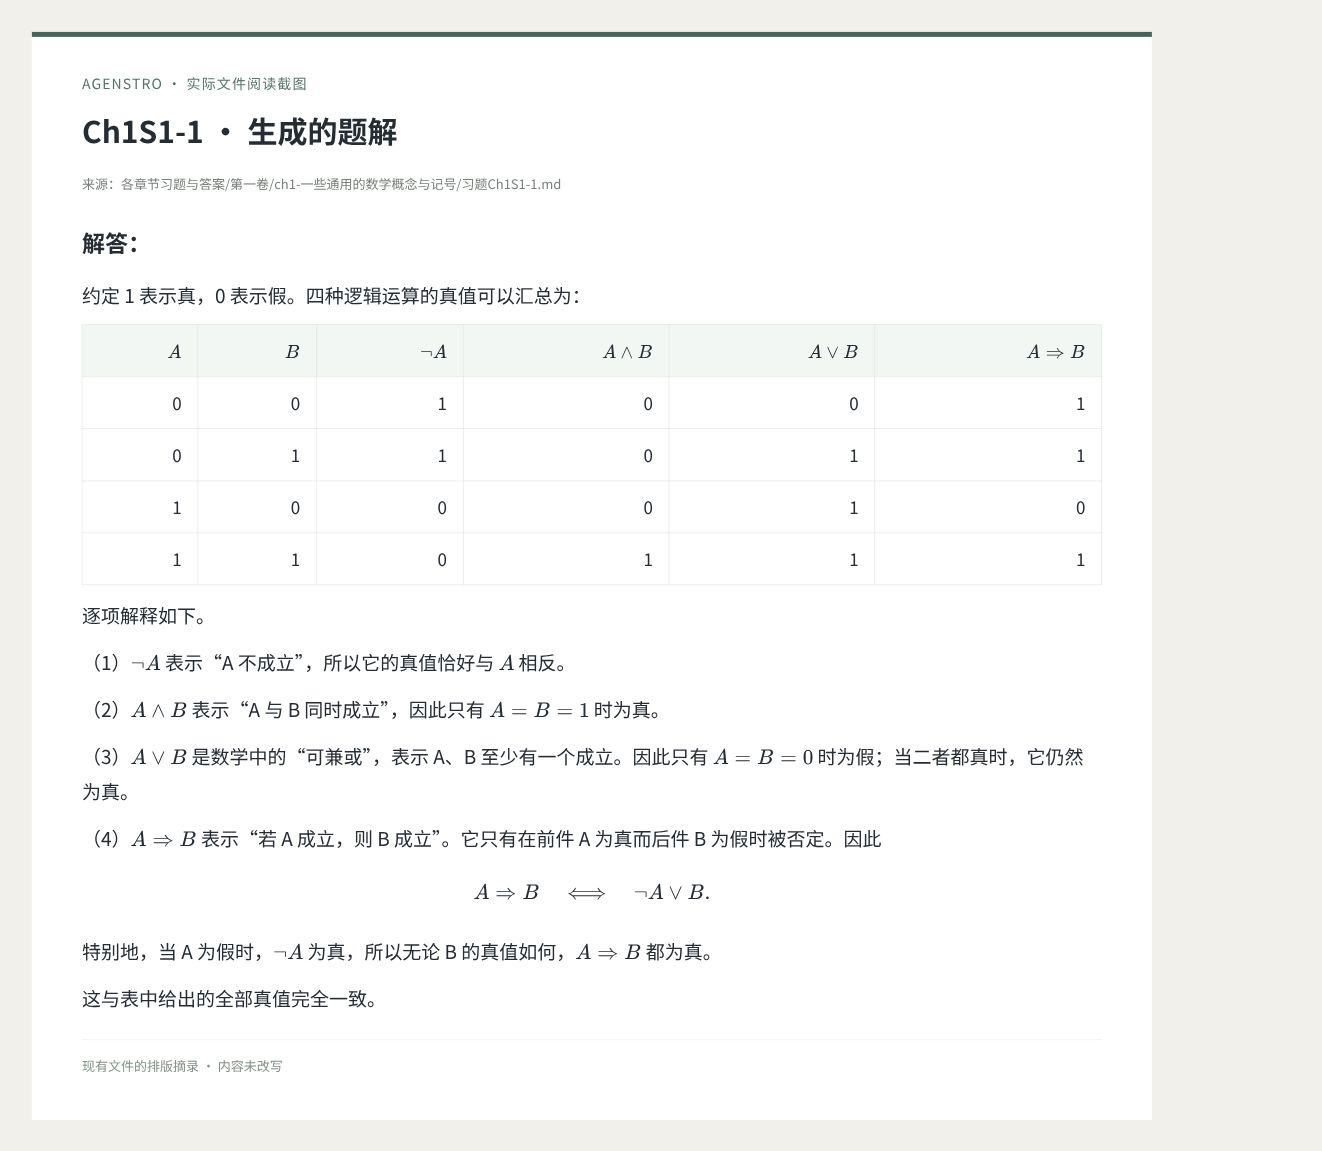
图 5:Ch1S1-1 的生成结果。程序保留了可以直接阅读的表格和逐项说明。
连续性题会先给定义,再把题目中的条件代入证明。
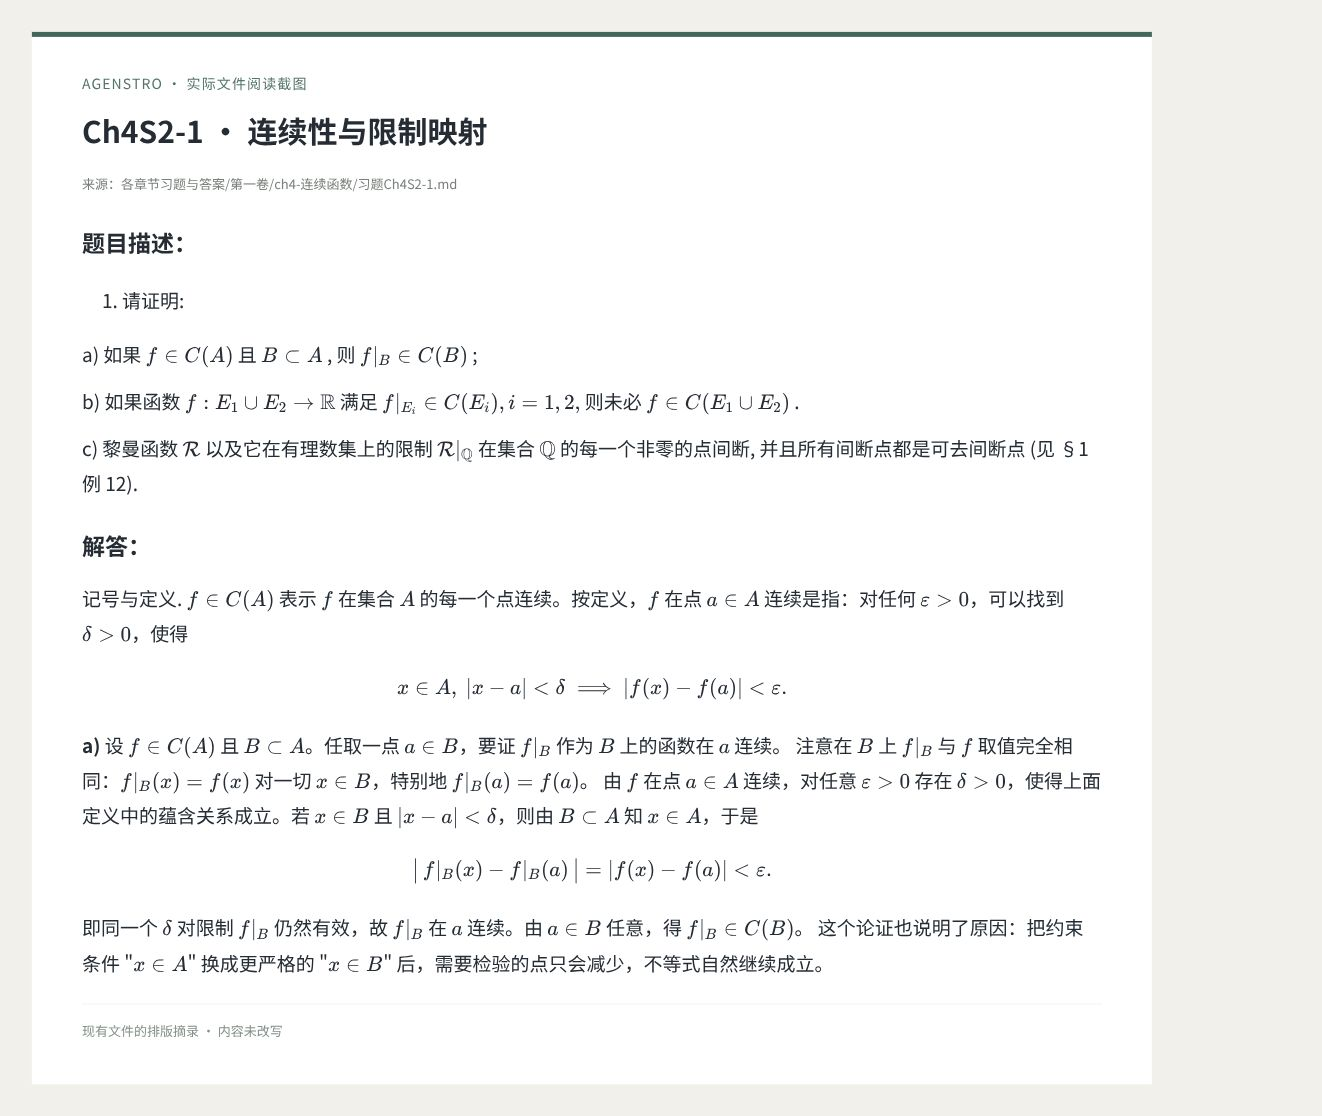
图 6:Ch4S2-1 的题干与解答开头。
几何题则会展开参数化、求导等中间步骤。
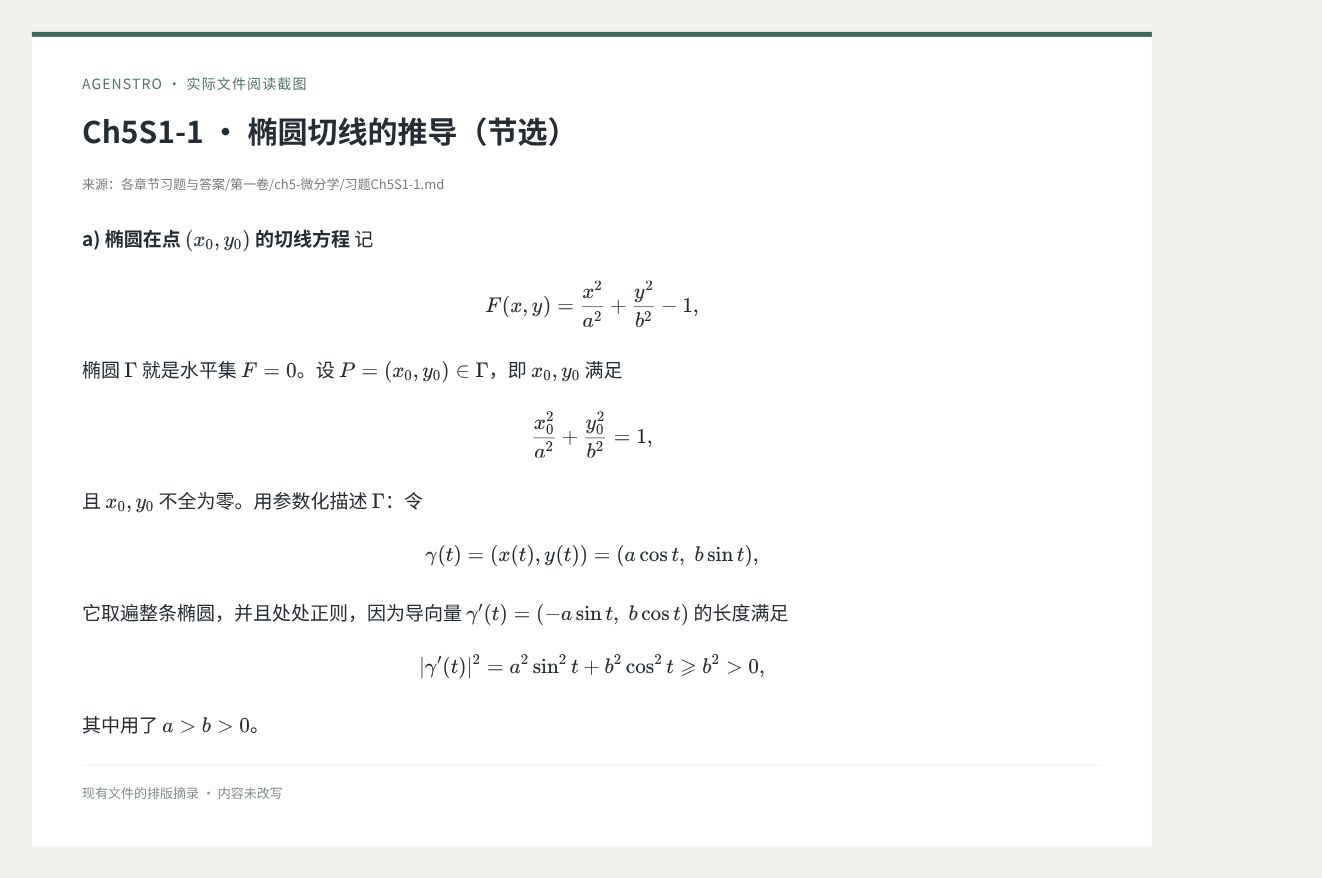
图 7:Ch5S1-1 中椭圆切线的推导片段。
第二卷的题解也保存为同样的文件形式,后续可以按题号定位和修订。
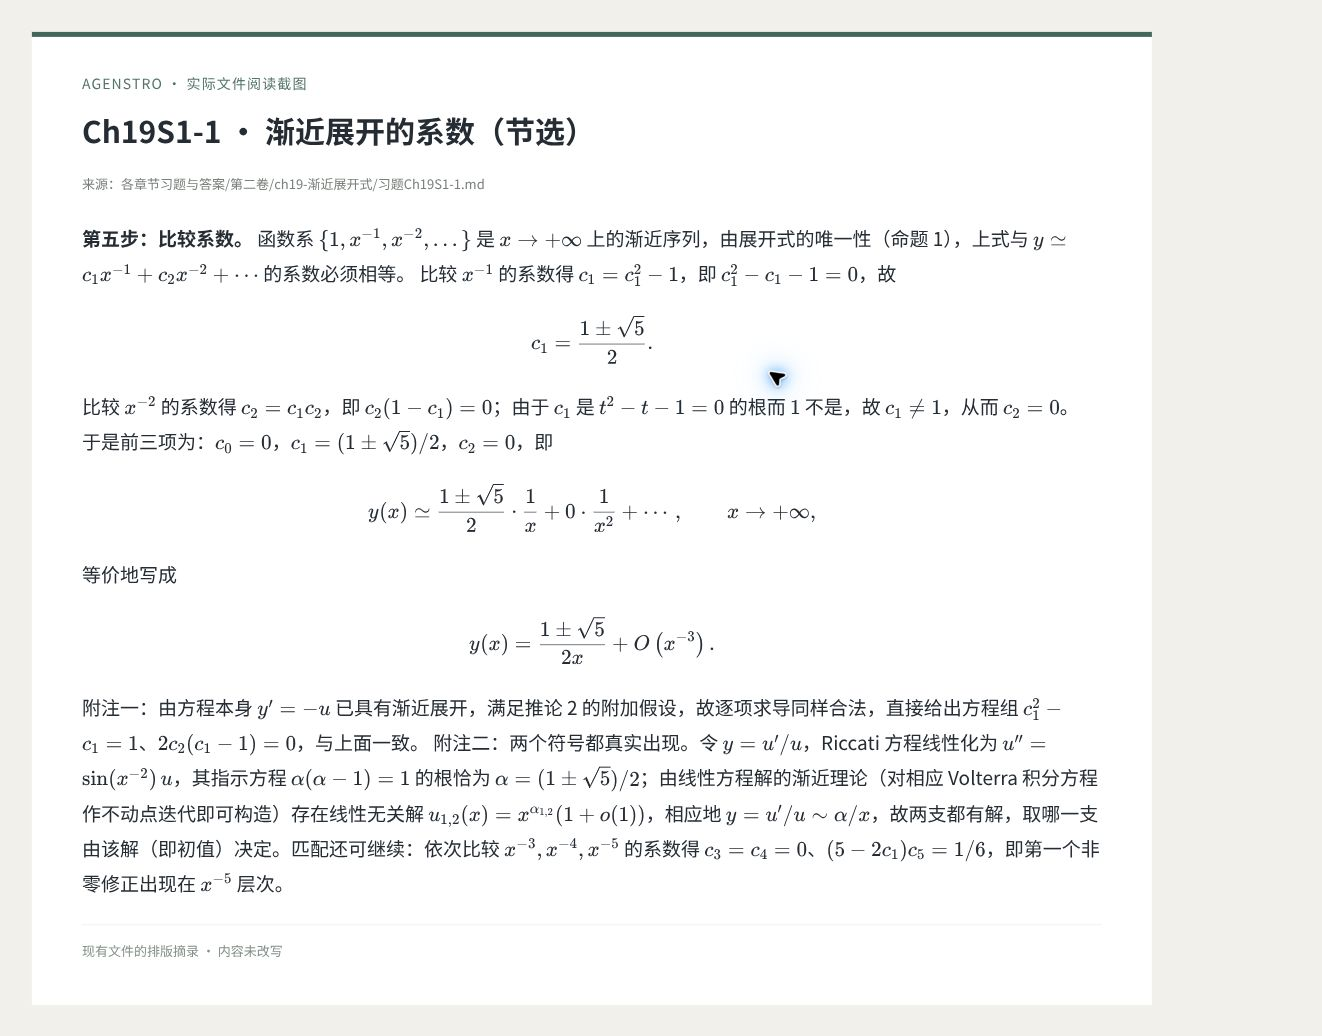
图 8:Ch19S1-1 中比较渐近展开系数的部分。
这是测试暴露出来,即便是对于看起来比较简单的工作流,也仍然存在大量潜在的未知因素。 不过至少证实了Agenstro这个框架在有codex作为守卫程序的前提下还是足够稳健的,此任务从开始到结束共5天,期间暂停人工介入的次数约为5-7次,说明整体可行。
第二个案例,Bourbaki PDF → LaTeX
最终结果:Tensorera/BourbakiMathLatex。
动机与目的
第二个案例希望把 Bourbaki 的 PDF 整理可重新编译的 LaTeX,并在英文版的基础上生成中文版。 或者换一种说法是,将PDF恢复其结构化的文本状态,这算是一种信息恢复。 这一方面方便人类编辑和注释(bourbaki众所周知的难读,但又极其精炼和完善)。
输入清单包含 23 个 PDF 单元,既有整卷,也有拆开的章节,记录的原文总页数为 9,101 页; 其中 15 个英文、8 个法文。 法文材料先转成英文,再进入中文流程,以便后续统一处理。
这里的典型工作流是: 英文pdf—OCR—>英文markdown —Structure retrieve—> 英文latex —Translate—> 中文latex —Reference Retrieve—> 超链接恢复的Latex。 对于法文原书则会先整理为法文latex再翻译。
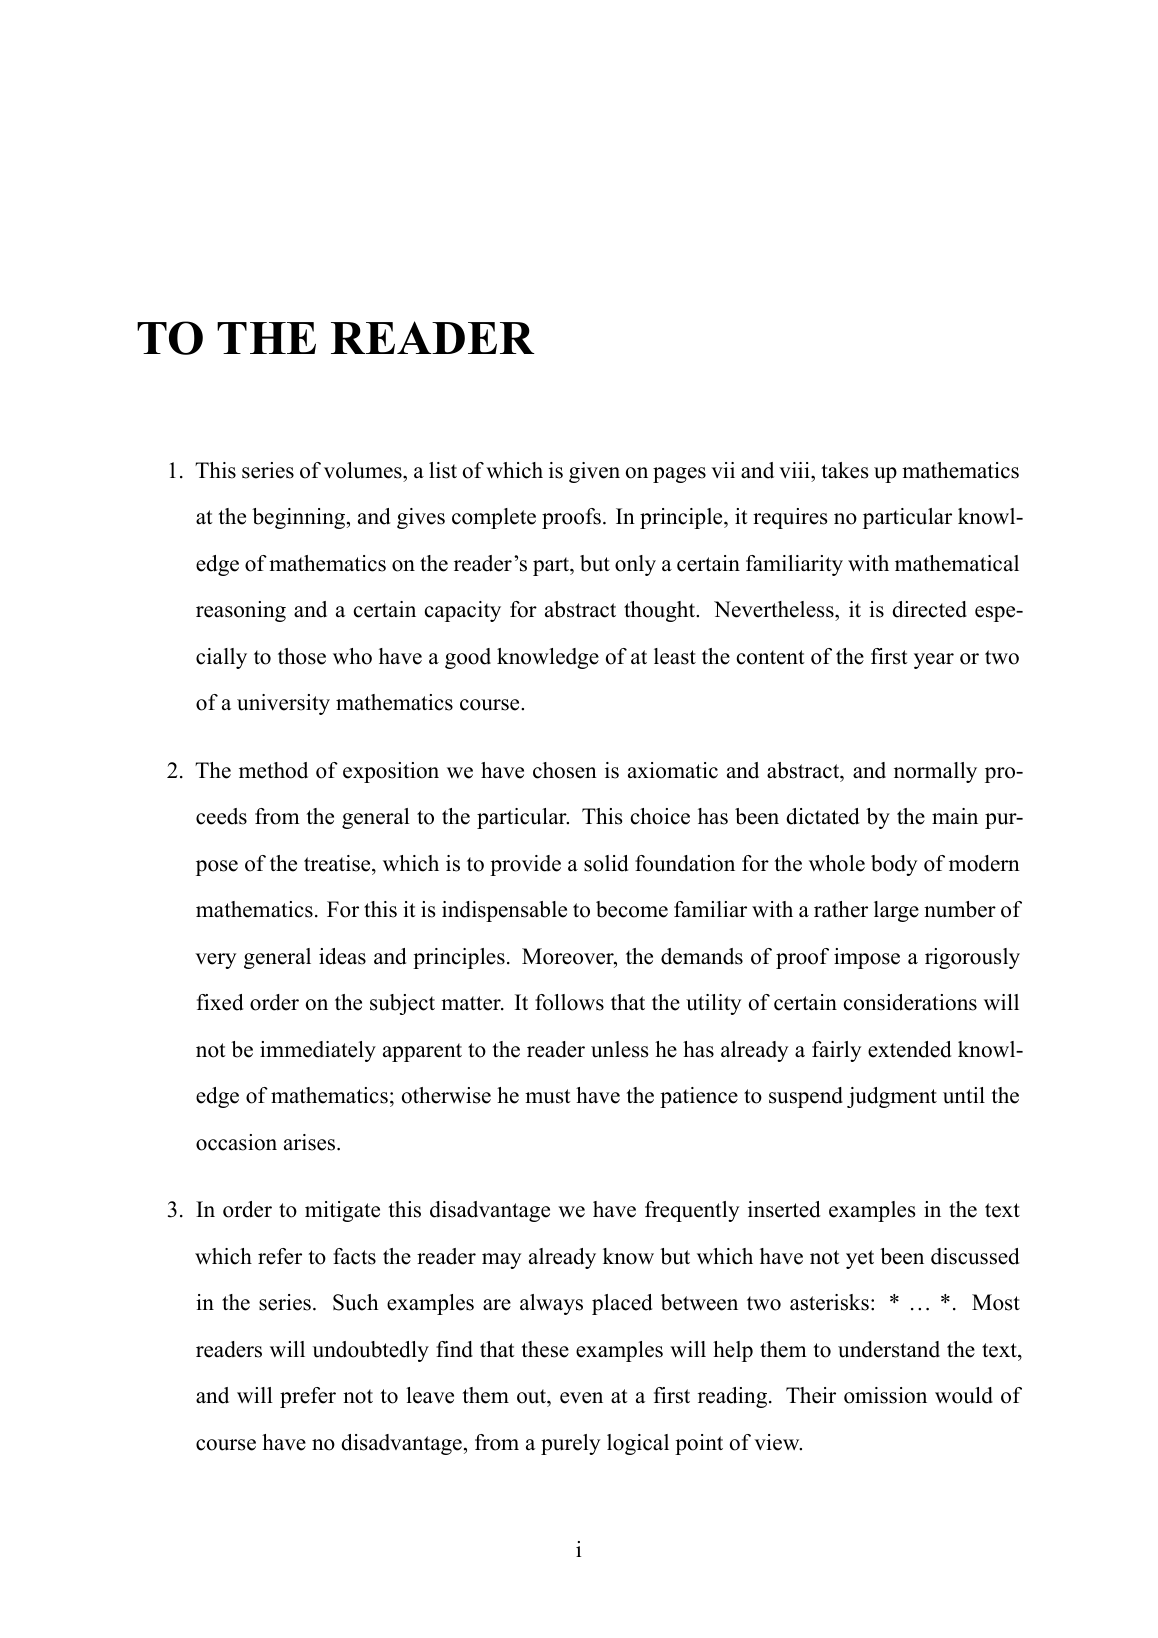
图 9:《集合论》英文成品 PDF 的第 2 页。
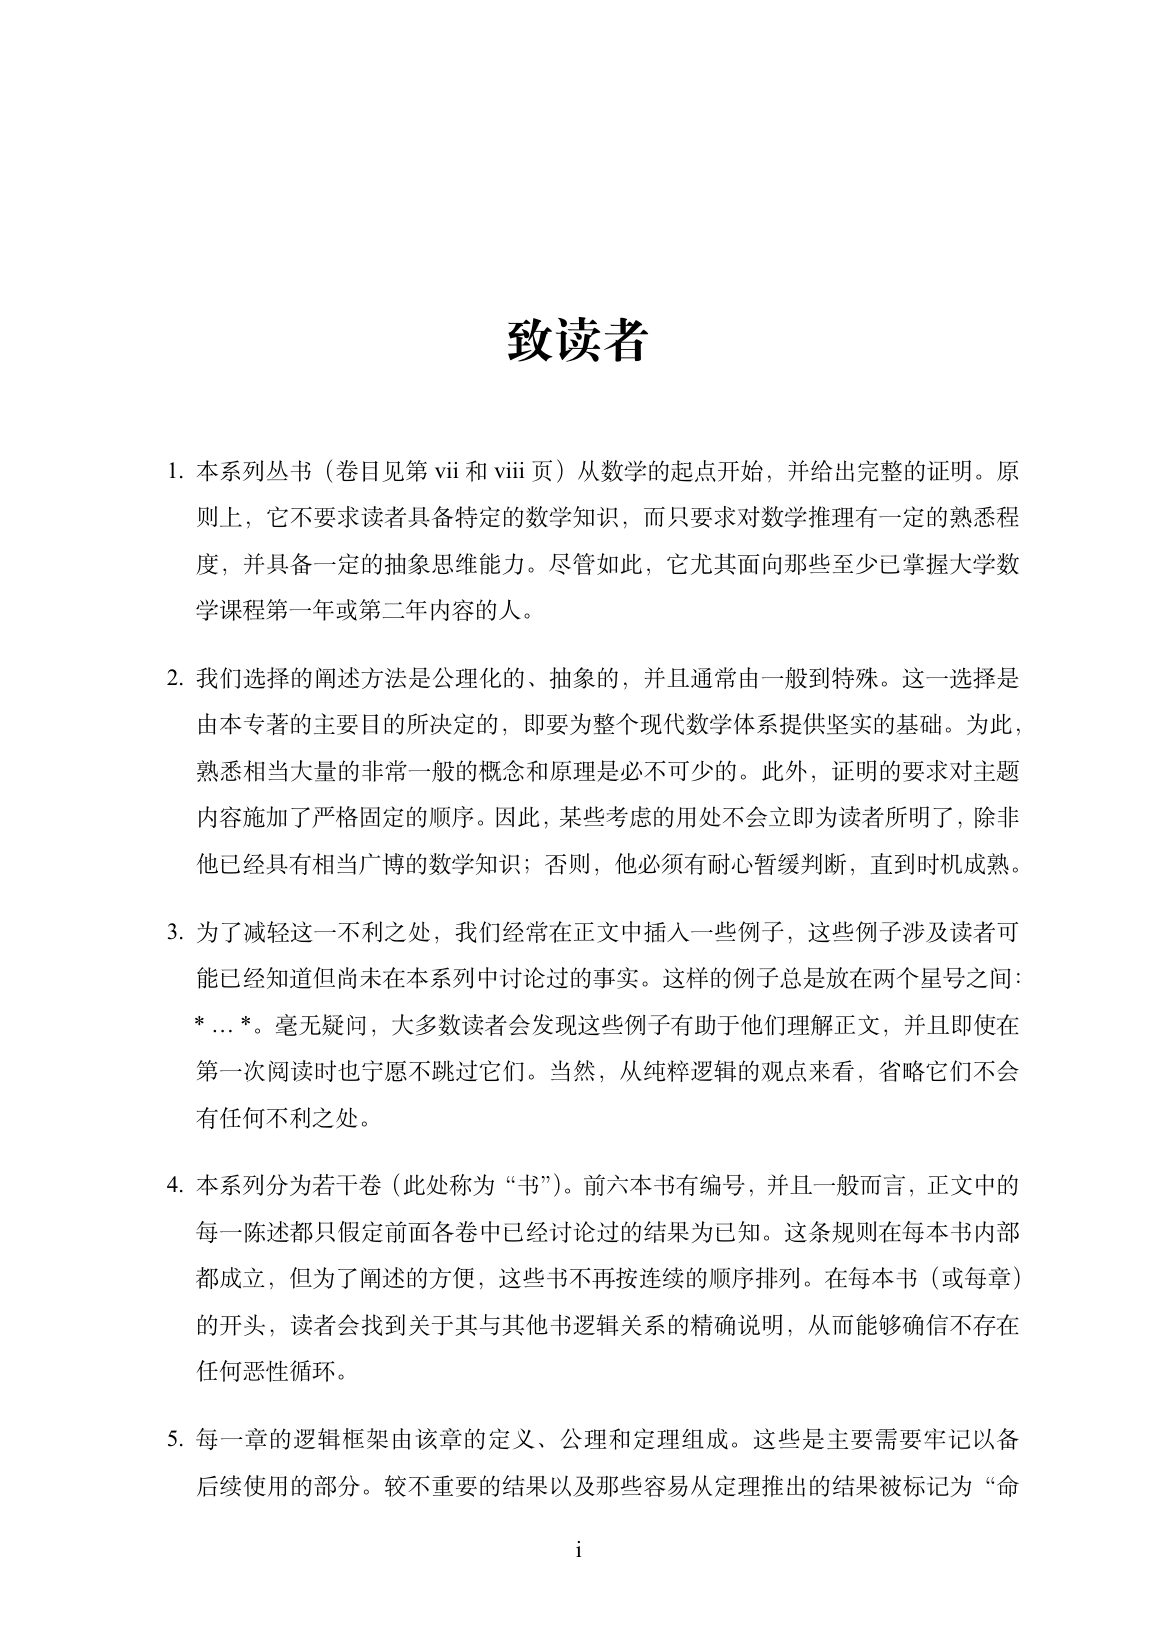
图 10:中文版的第 2 页。正文变为中文,分页也随排版重新产生。
Tactus 把整个过程分成几类步骤:
- 阶段:提取;主要脚本:
010/100;任务:拆分 PDF,调用 MinerU,保存 Markdown、图片和识别证据 - 阶段:英文整理;主要脚本:
110_build_english_generic.hs;任务:从识别结果建立 LaTeX;修复 OCR 问题,法文片段译为英文 - 阶段:中文初稿;主要脚本:
120_translate_chinese_ds.hs等;任务:翻译自然语言部分,保留 TeX 结构 - 阶段:中文校订;主要脚本:
130_polish_chinese_generic.hs等;任务:按卷建立术语表,对照英文逐片段校订 - 阶段:验证与编译;主要脚本:
040_verify_latex.hs等;任务:运行结构检查和实际编译;编译失败时进入专门的修复步骤
这里模型任务的产物主要是磁盘上的 .tex 文件。
编辑任务只返回一行 OK: 或 FAILED:,工作流还会独立检查文件,确认符合要求后才记录完成。
问题与改进
第一个问题是翻译会顺手改坏结构。 给模型输入带格式的文本,很容易改动括号、命令、公式或引用,导致格式损坏无法编译; 因此,翻译流程把公式、命令、标签、路径等结构部分锁定,只把自然语言片段交给翻译步骤。 英文修复与中文校订又有不同的权限: 英文整理可以根据原 PDF 做必要的 OCR 结构修复,中文校订则要求保持既有结构。
注释:颇为神奇的是agent自己知道翻译过程中要维护一个术语表(terminology manifest)以提升翻译准确性。这可能是将agent calling作为最小原子单元的一个潜在好处——充分利用llm已经内化的技能。
中文校订的 prompt 大致如下:
只修改指定的中文 LaTeX 片段,以对应英文片段为依据,并参考本卷术语表。 修正误译、数学方向颠倒、术语不一致和未翻译的正文;不得概括、删节或扩写。 保留命令、环境、公式、标签、计数器、路径、括号和换行序列。 长片段分段处理,每完成一段就保存。 完成后运行指定的
latex_guard.py检查,通过后才返回OK:。
工作流收到 OK: 后还会再运行一次检查。
prompt 负责告诉模型应当怎么做,程序负责判断实际文件是否满足可检查的约束。
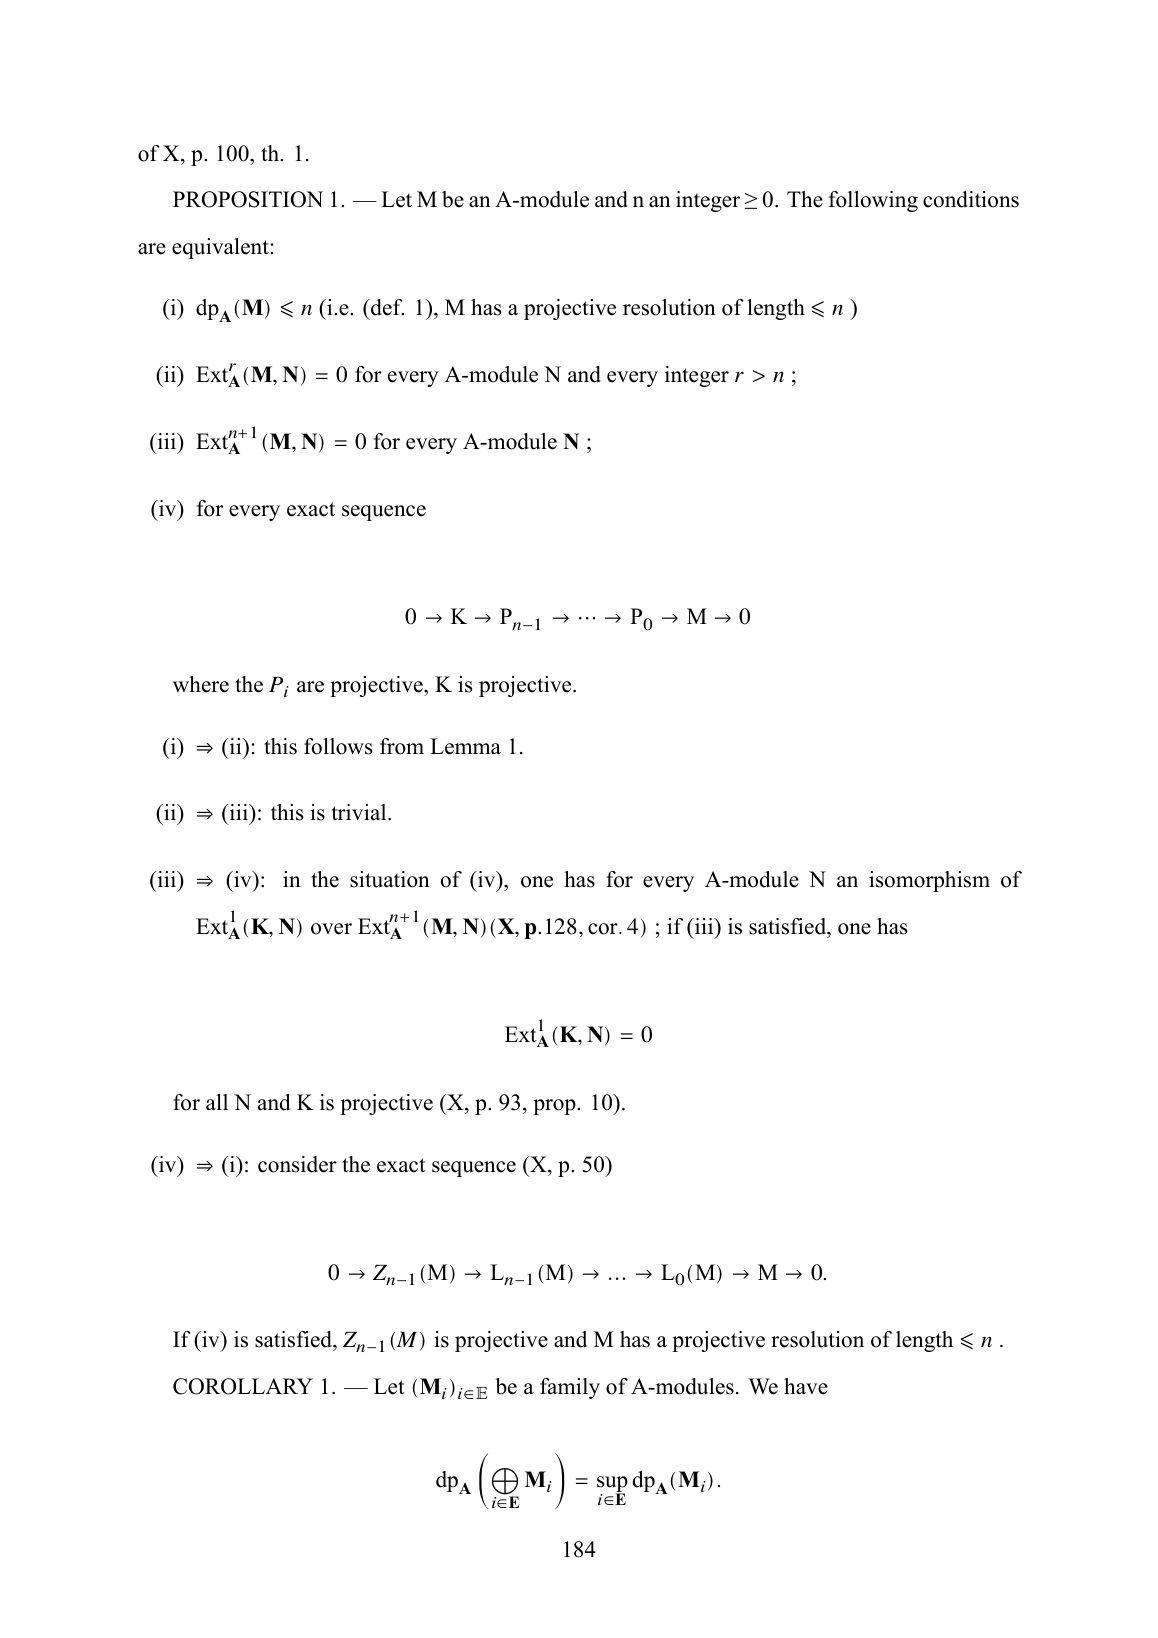
图 11:原始材料为法文的《代数》第 10 章,英文成品 PDF 第 189 页。
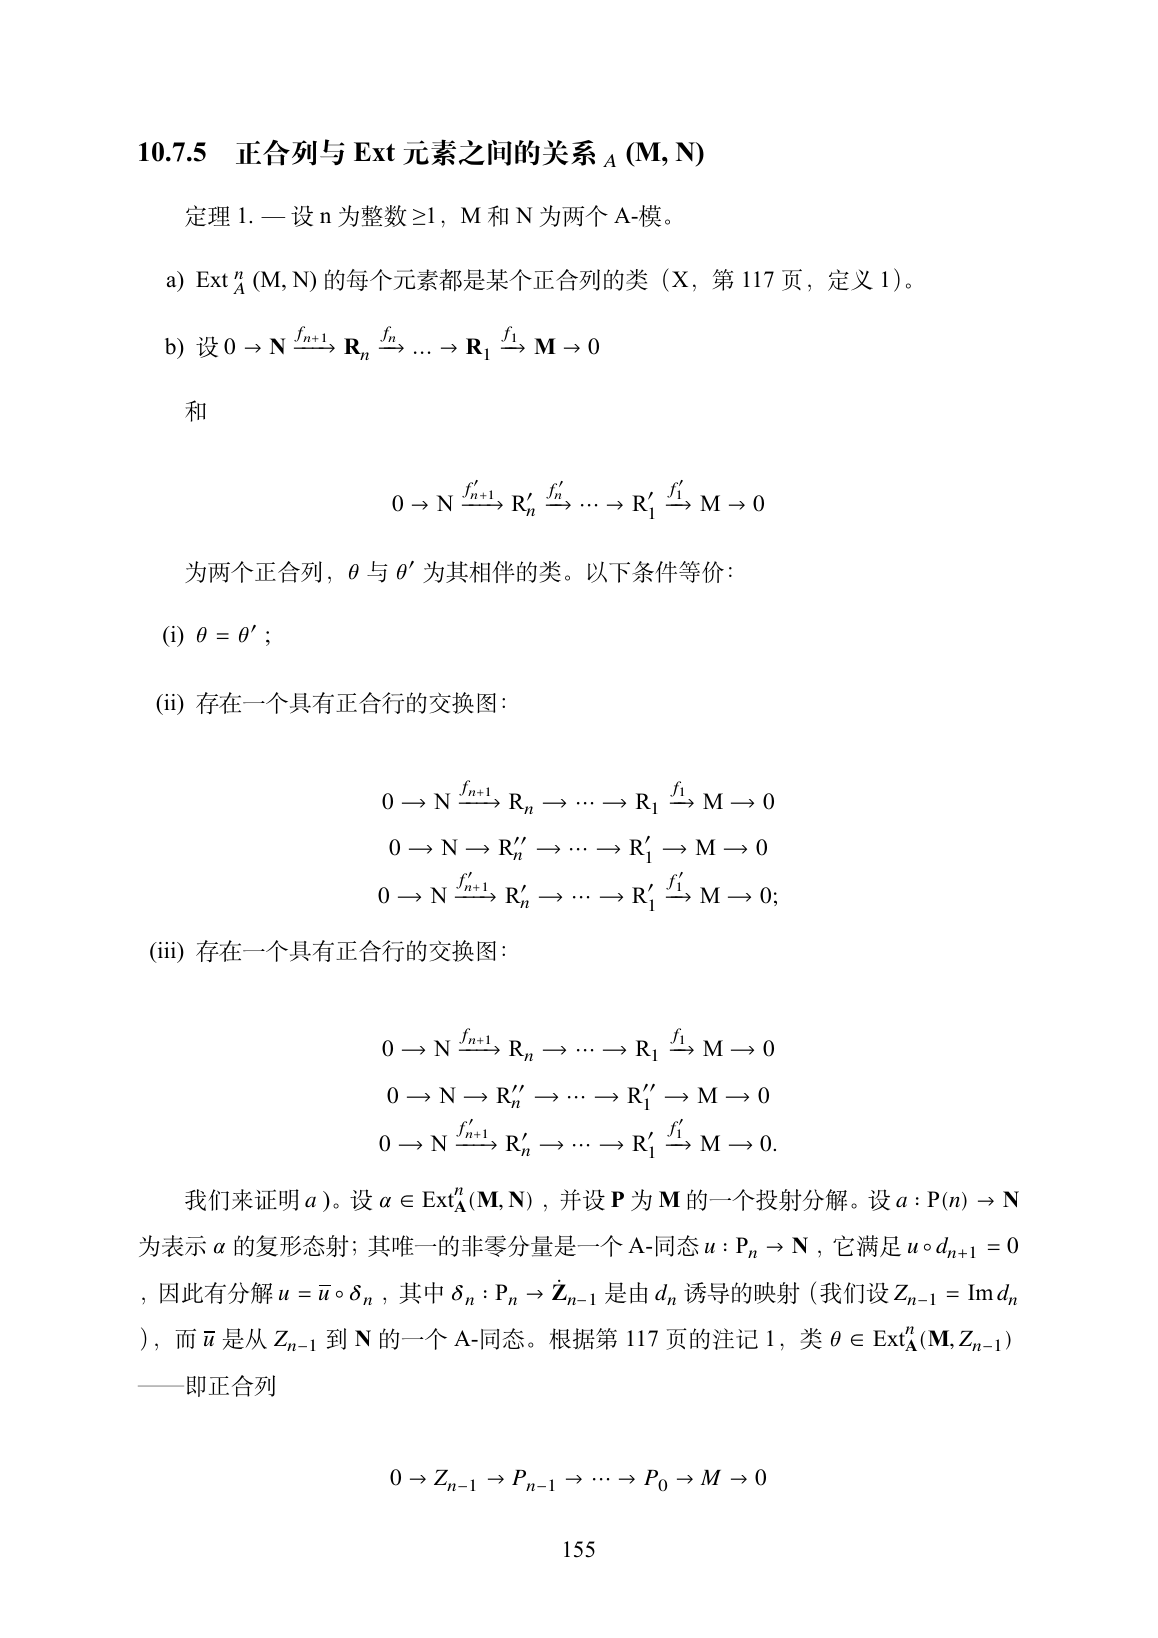
图 12:同卷中文成品 PDF 第 160 页。复杂公式和正合列仍是需要单独核对的重点。
**第二个问题是大批量任务一定会遇到中断。 ** 项目记录里出现过 DeepSeek 额度耗尽、调用超时,以及文件已经修改、调用结果却未正常返回的情况。
后续脚本把完成状态细化到片段:已完成的翻译可以复用,长片段及时保存; 遇到结果未知时,检查文件是否实际变化、是否通过独立验证,再决定能否补记完成。 GLM 调用还使用全局六个并发槽,避免多个批处理脚本同时启动过多任务。
DeepSeek 停用后,流程提供了“以英文片段为基底,再由 GLM 翻译校订”的路径。 复制英文只是在准备待处理文件,不能据此标记中文翻译完成,后面仍需检查英文残留及内容变化。
第三个问题是外围工程也会让任务失败。 例如 Windows 下的中文路径和输出编码、对大工作区做全量哈希的开销,以及恢复时使用旧目录别名而被路径范围检查拒绝(这一部分是Agenstro workpath plugin出现了性能瓶颈)。 这些问题分别通过 ASCII 工作路径、UTF-8 输出和针对目标文件的检查来处理。
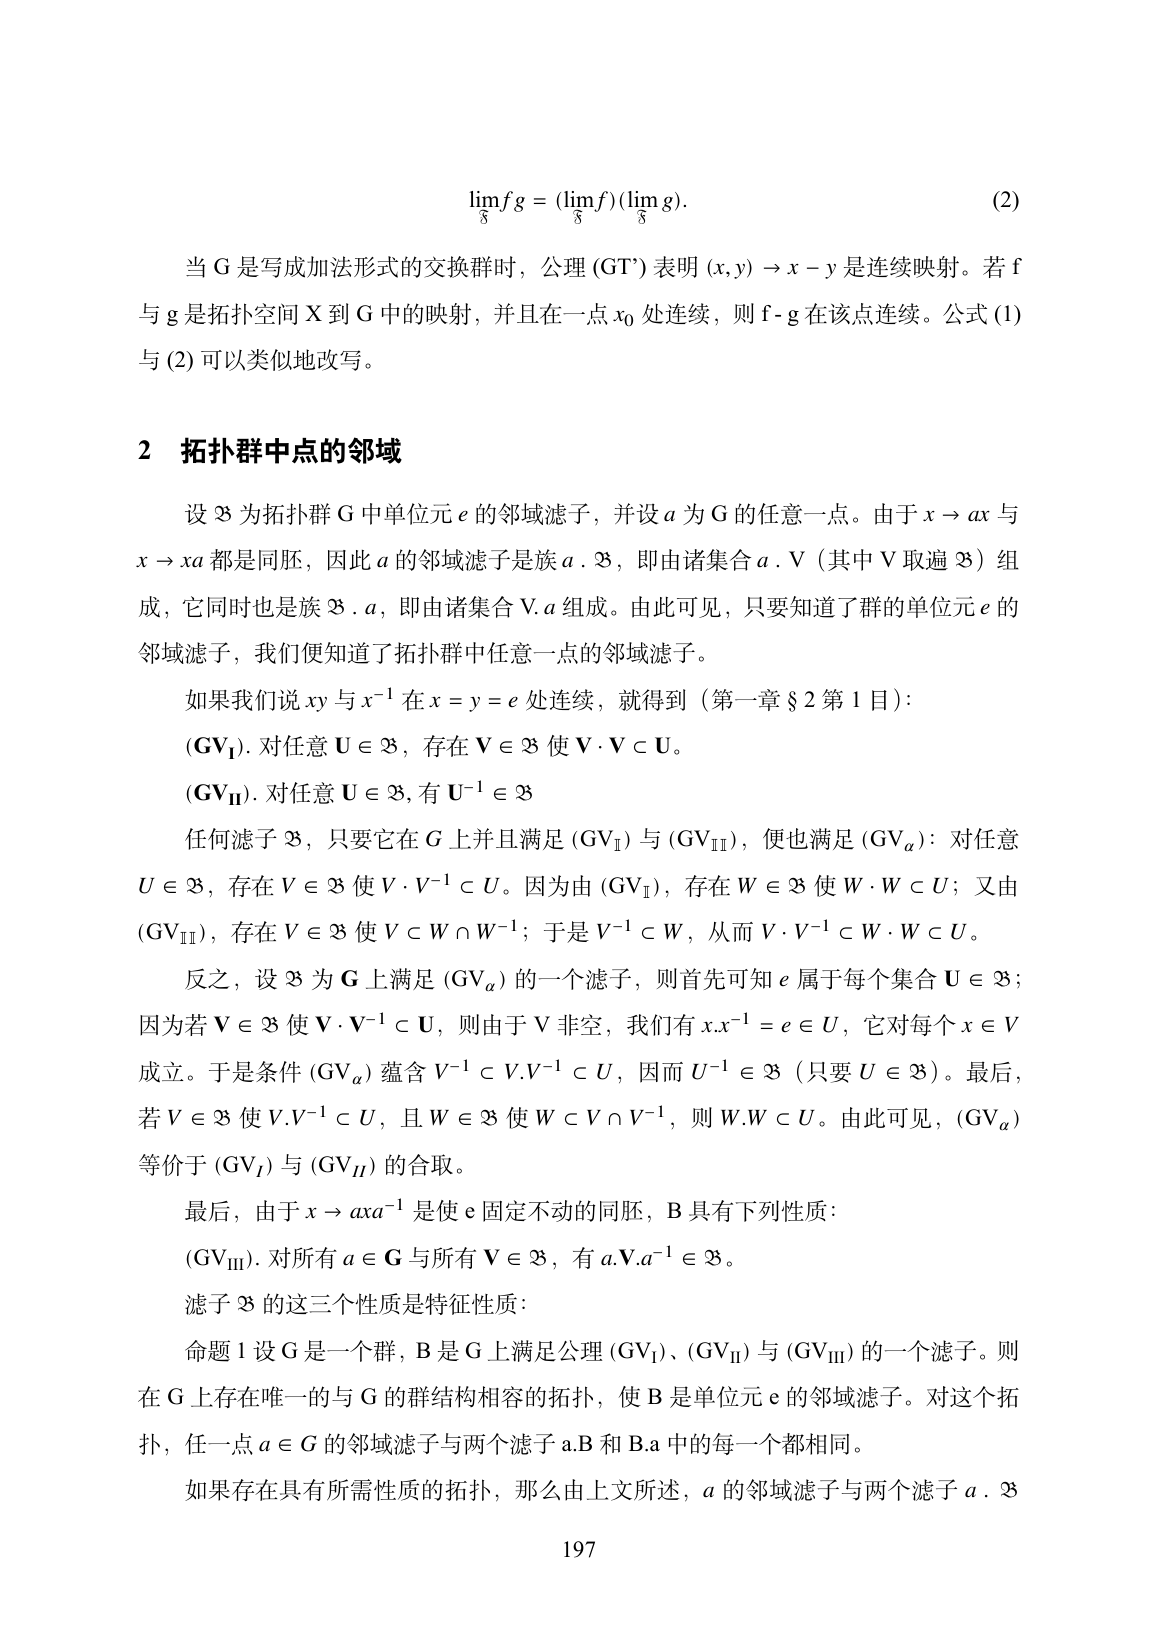
图 13:《一般拓扑学》第 1–5 章中文版第 207 页,展示正文、分节与公式的混排。
最后仍然需要真实编译和看图。编译负责发现 TeX 错误,页面抽查则用于检查标题、页眉、字体和公式是否正常显示;这两步各自能发现的问题不同。
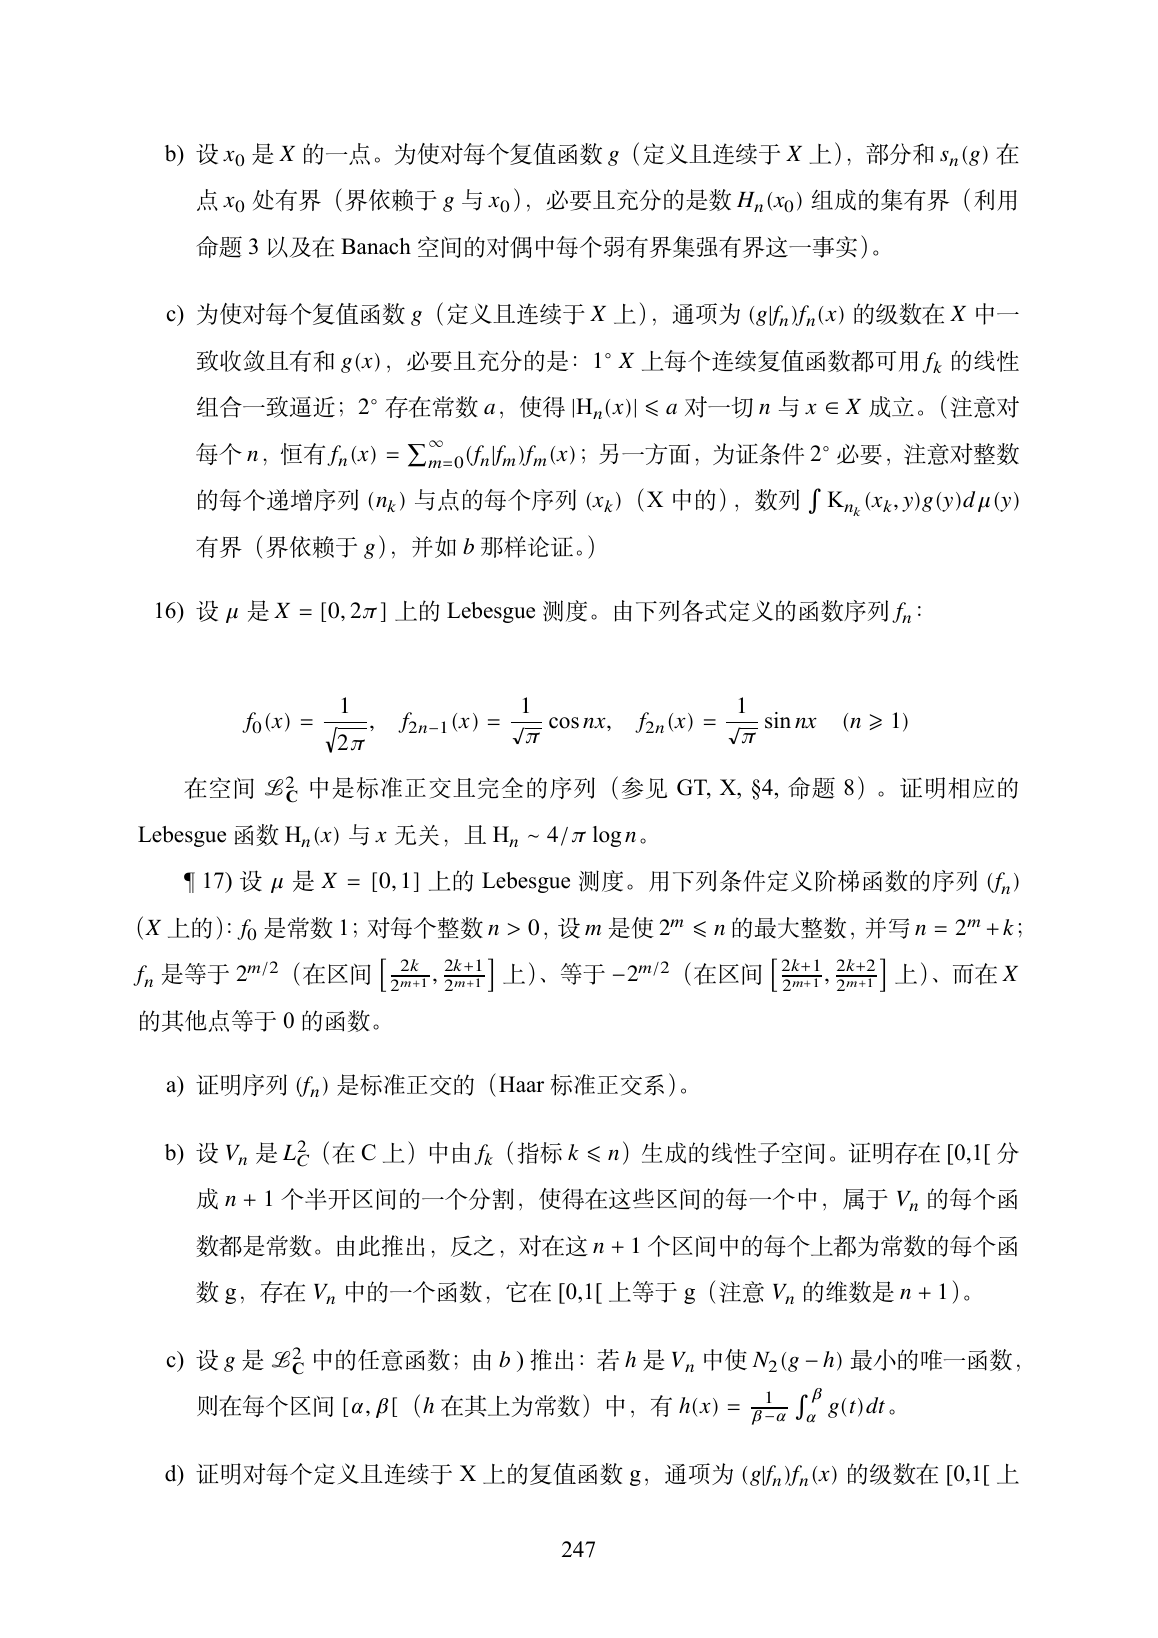
图 14:《积分》第 1–6 章中文版第 257 页。习题和正文一起保留在重排结果中。
最终形态
当前 ConvertedLatex(EN) 和 ConvertedLatex(CH) 各有 23 份 main.pdf、330 个 .tex 片段。每个单元还保留 main.tex、图片及相应清单,便于继续校对和编译。
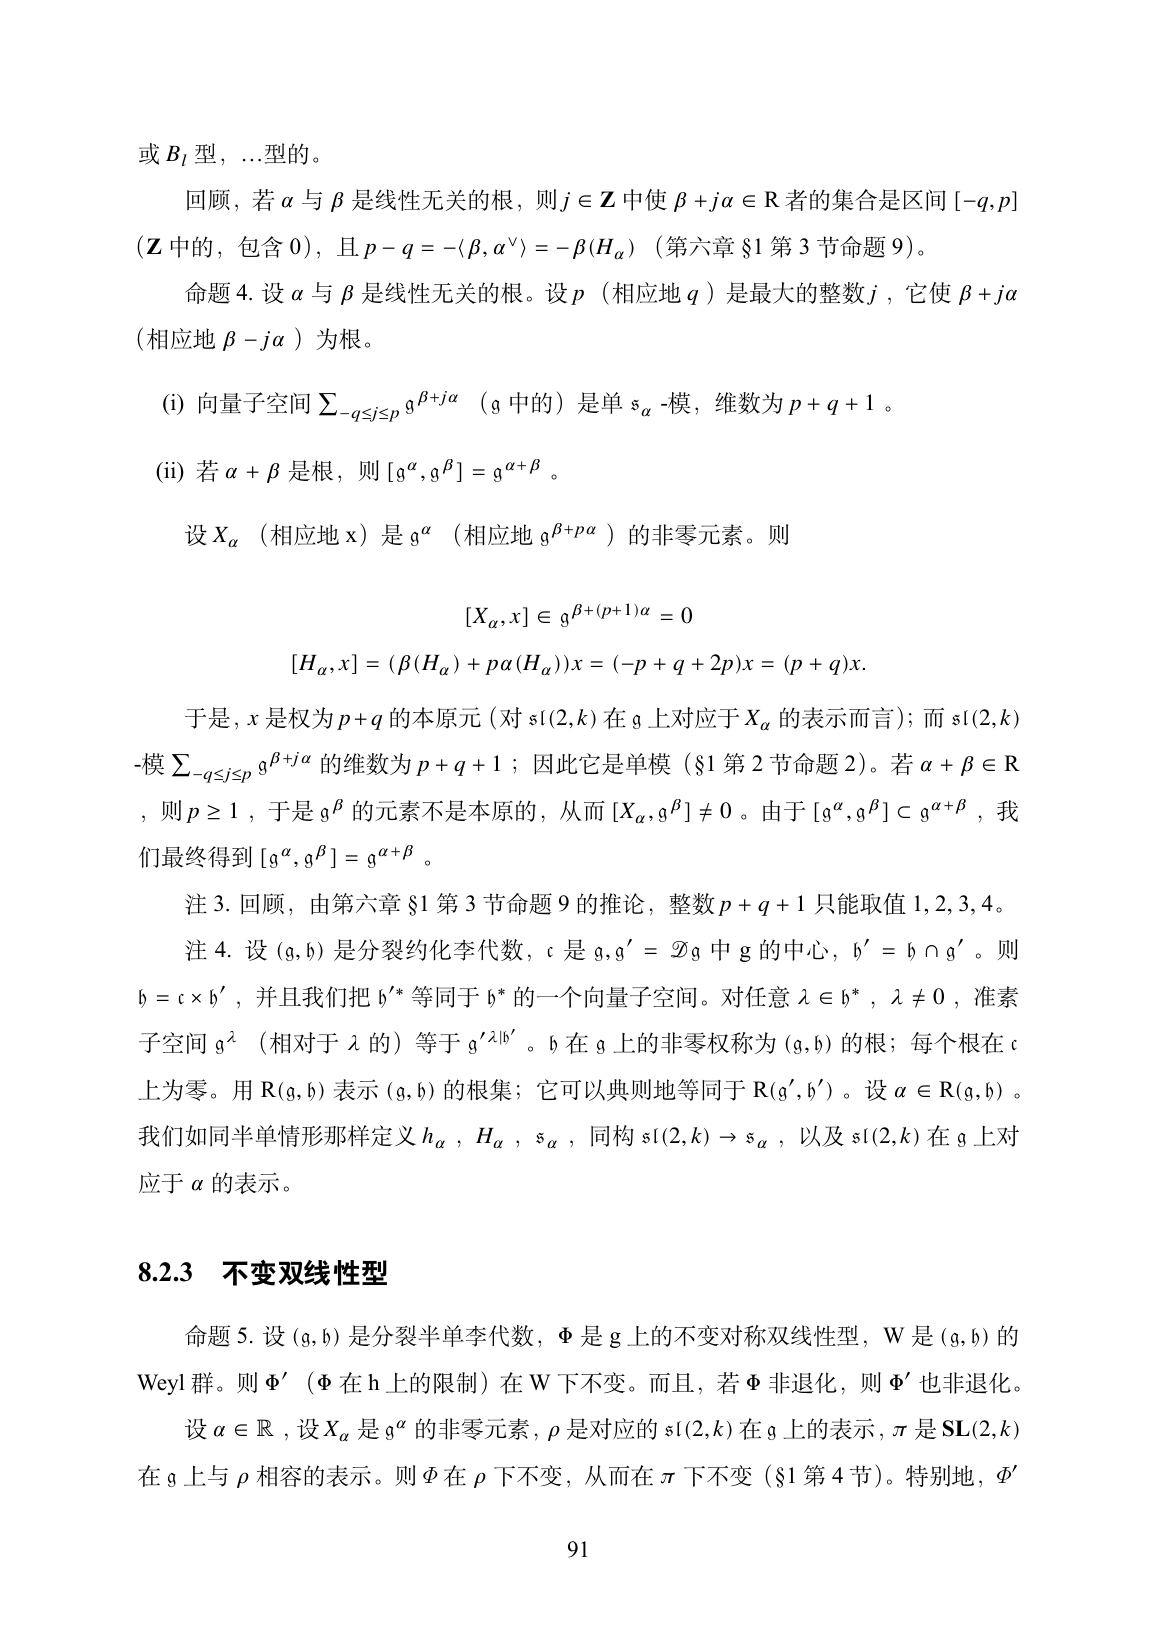
图 15:《李群与李代数》第 7–9 章中文版第 100 页。
长篇自然语言材料也进入了相同流程,例如数学史部分。
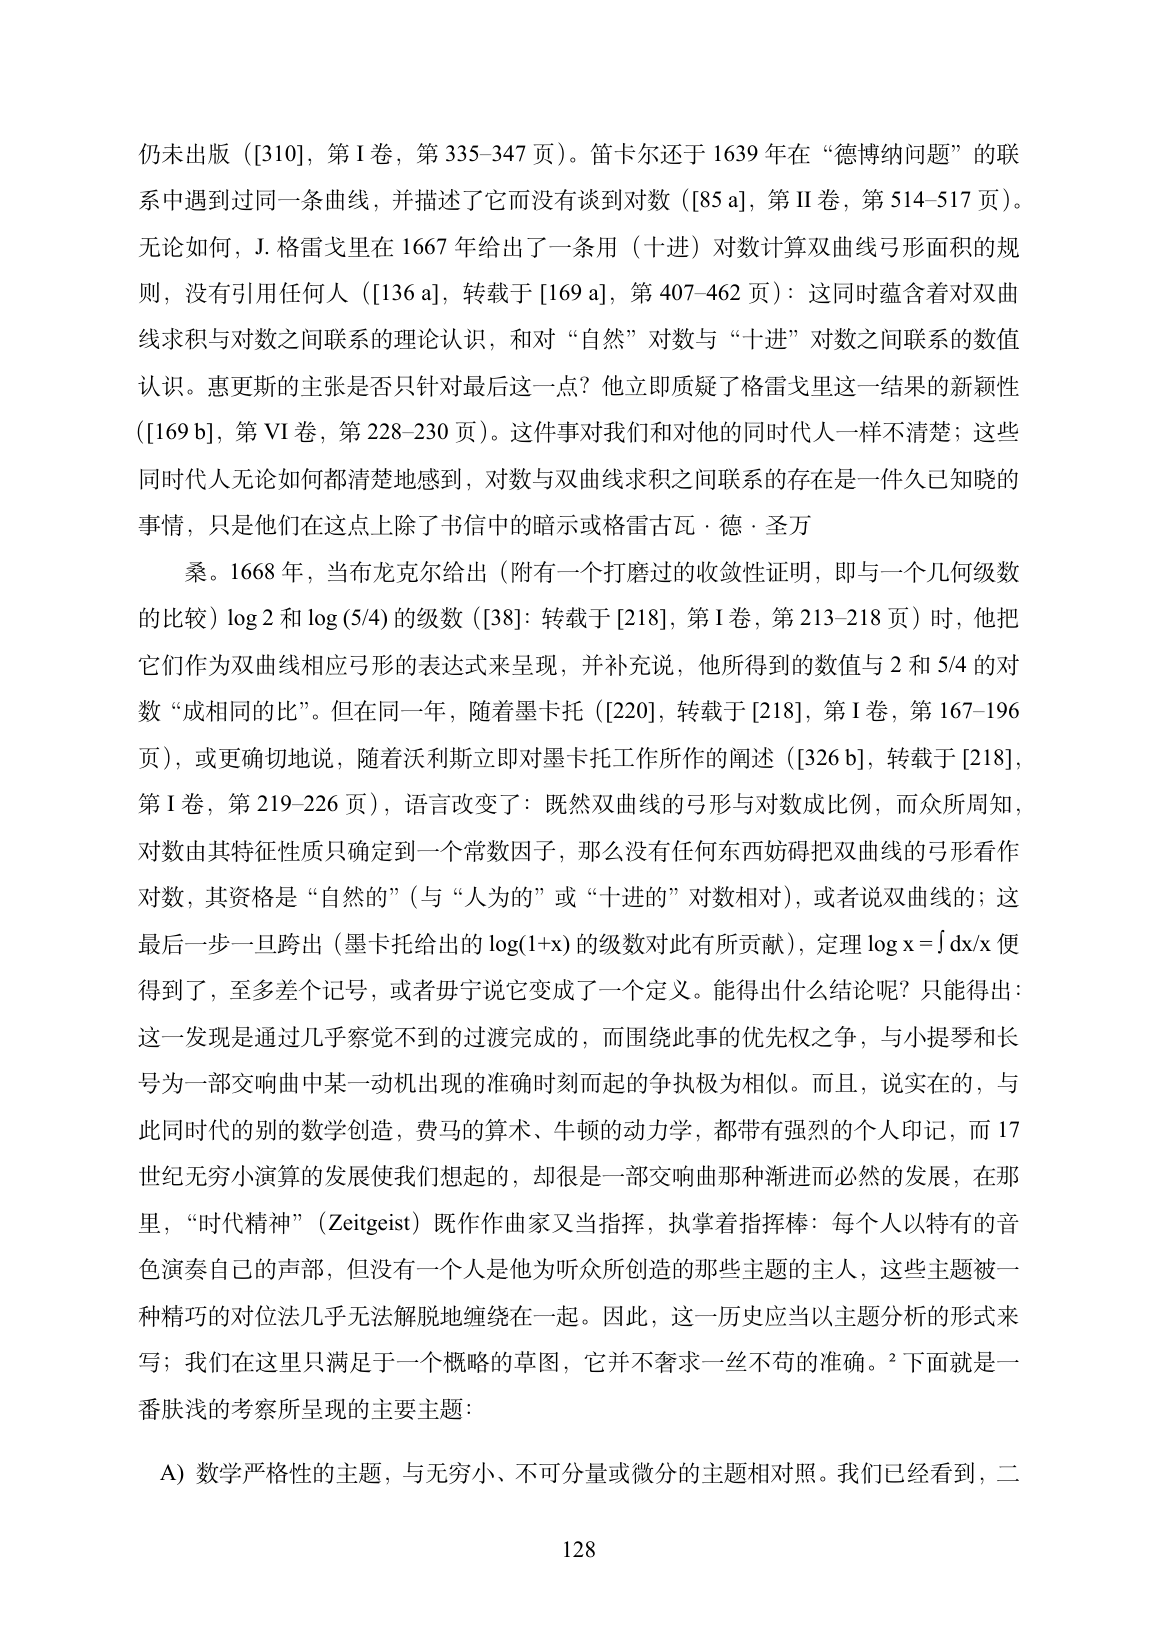
图 16:数学史中文版第 133 页。
这次测试留下了 46 份成品 PDF 和对应的可编辑源文件。结构检查、编译和抽样看图能够发现一批工程问题,但还不能说明九千多页原文已经逐段忠实还原。OCR 识别、数学翻译和引用对应仍然需要校对。
第三个案例,nnhr 全自动烤肉
动机与目的
“烤肉”指给日语视频制作翻译字幕。 这个案例使用 Nanahira 的生日回顾直播,目标是从视频一路生成日文转写、中文和英文字幕、审阅报告,以及已经压好字幕的视频。
它适合测试另一种工作流:模型判断和确定性工具交替运行。 模型处理日语分句、术语、翻译和审阅; 提取音频、运行语音识别、计算时间轴、保存文件和压制视频,由 ASR、FFmpeg等 工具完成。
- 脚本:
010_transcribe.hs;作用:用 FFmpeg 提取音频,运行 faster-whisper,得到带时间戳的转写 - 脚本:
015_assemble.hs;作用:选择语义边界,再由程序组合句子、切分显示字幕 - 脚本:
020_terms.hs;作用:提取人物、作品、专名和梗,提出术语候选 - 脚本:
030_translate.hs;作用:按窗口生成中文、英文字幕,检查并修复不合格的回答 - 脚本:
040_review.hs;作用:另开模型调用审阅译文,生成问题标记 - 脚本:
050_publish.hs;作用:输出两种硬字幕视频和软字幕封装
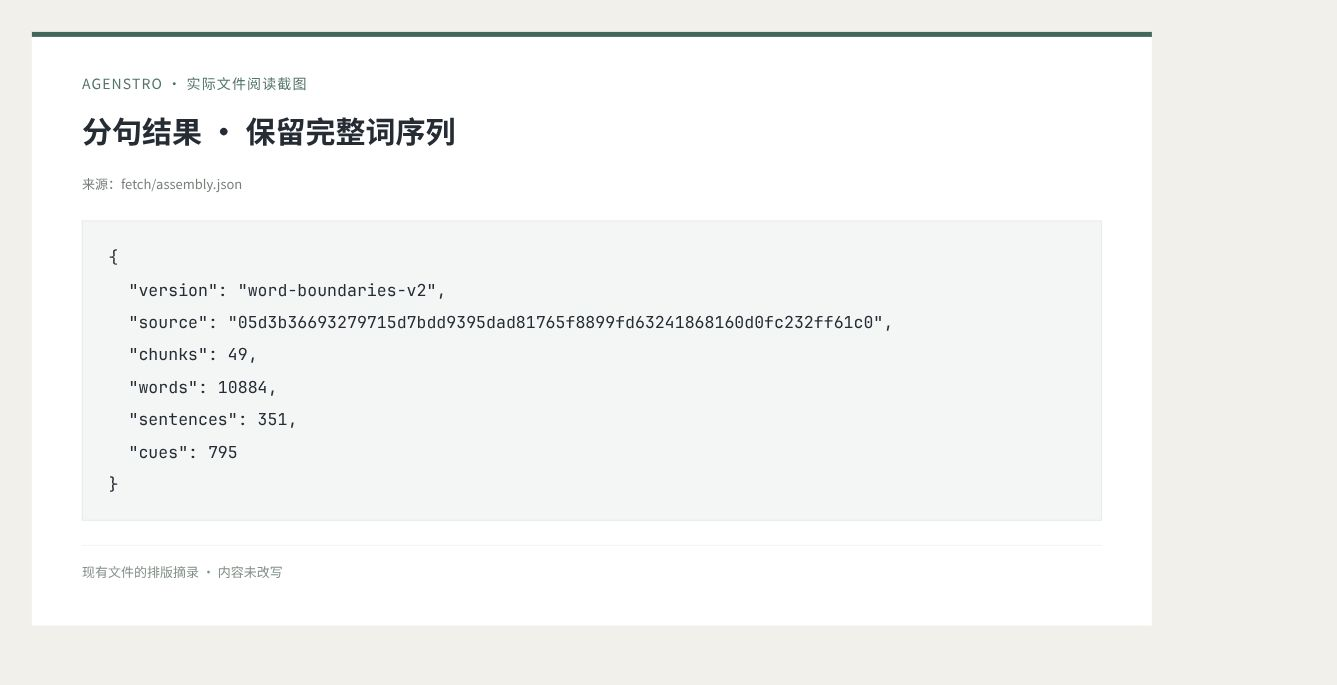
图 17:现有分句结果包含 49 个处理块、10,884 个带时间戳的词片段、351 个语义单元和 795 条显示字幕。
语义单元和显示字幕是两层数据。一个完整意思可能太长,程序会把它拆成几条适合屏幕显示的字幕;翻译时仍然提供完整语义和前后文。
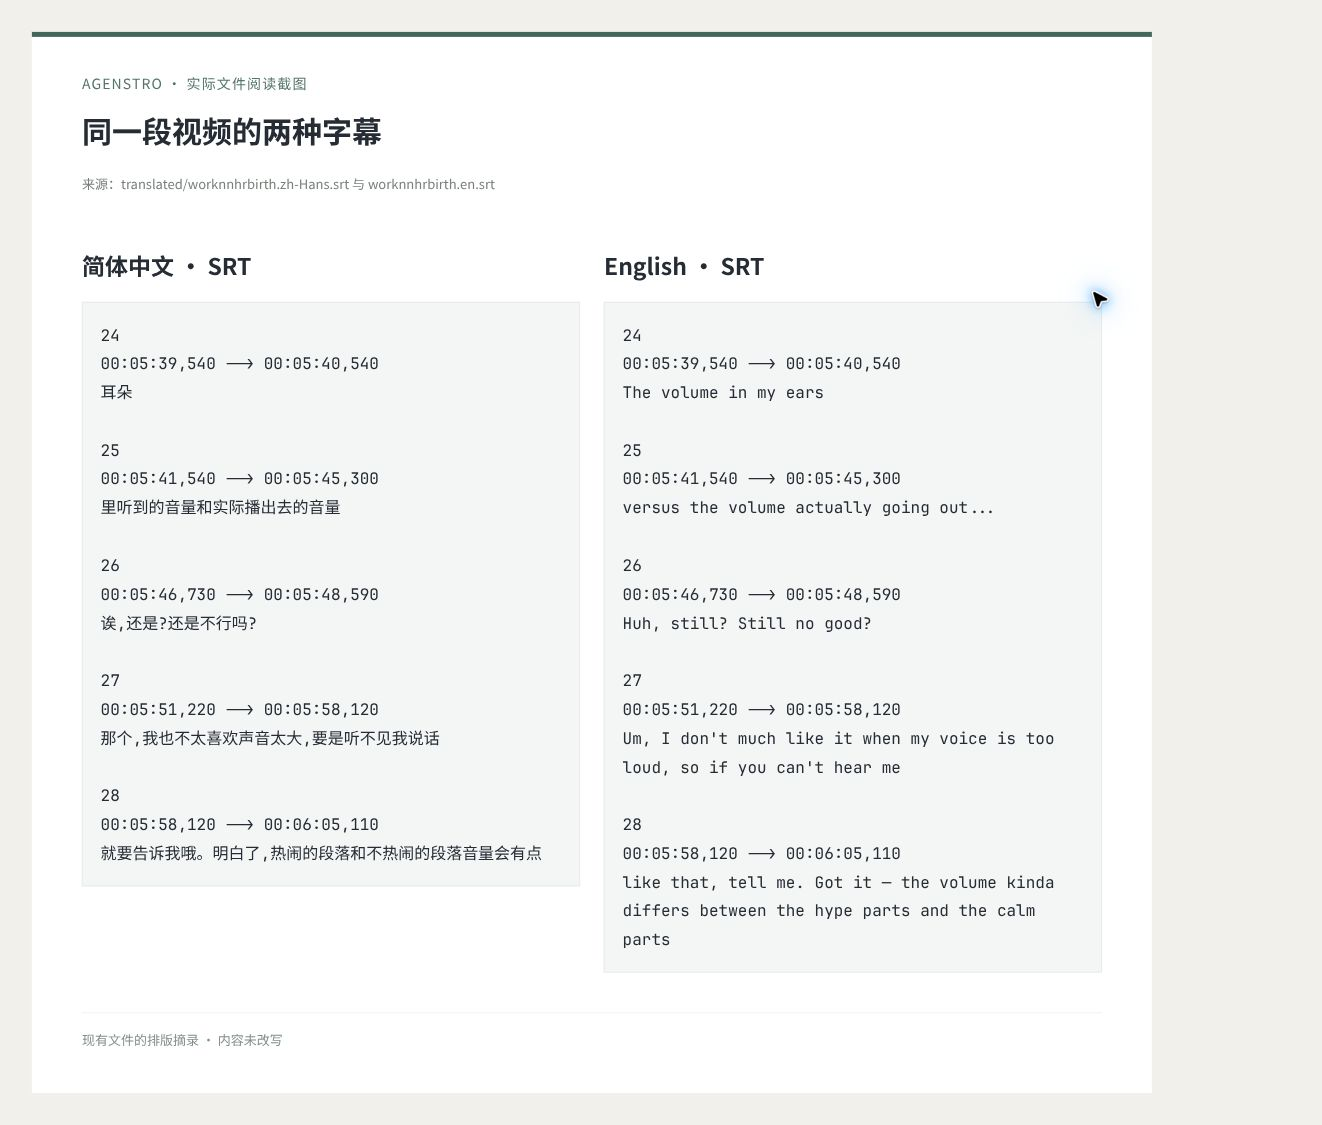
图 18:同一段视频的中英文 SRT 摘录。两种语言沿用相同的字幕编号和时间轴。
问题与改进
第一个坑是让模型做了太多机械工作。 早期分句把大量碎片和时间戳交给模型,让它重新拼文字、抄时间、数编号。 成本记录中的 16 次旧模型调用用了 125,857 个推理 token,最终回答却只有 8,815 个 token。
更严重的是校验范围不够。 项目记录里有一次回答漏掉了 191 个词中的 69 个,但剩下的每一行都符合局部规则,检查仍然通过。
现在的做法是让模型只选择边界。 程序先把原始转写整理成较易读的日语短语行,每行的编号表示它在原始词序列中的结束位置。 分句 prompt 可以压缩为:
把连续短语组合成完整意思;行末只是候选边界,语法未结束时继续合并。 每组只返回最后一行的编号,不抄原文,不复制时间戳,不重新编号。 编号必须来自输入、严格递增,并包含最后一个编号。 返回
{"ends":[结束编号…],"continues":false};跨块未结束时标记延续。
程序据此取回原文和时间,检查每个词是否恰好覆盖一次,并在所有块完整后才提交分句结果。 有效块会立即保存; 收到格式错误的回答时,修复请求会带上原回答和具体错误。
第二个坑是术语和口语语境。 人名、歌曲名、角色名和梗经常不能逐字翻译,而语音识别本身也可能把名字听错。项目先提出术语候选,再给每个翻译窗口附上相关条目; 已确认术语作为约束,未确认条目暂作默认译法。
注释:这里笔者测试的时候遇到了硬边界,很多专有术语集由爱好者群体自发进行翻译与校核。nnhr直播时有可能出现一些全新的术语,这些内容大模型无法进行自动确认,例如这次生日直播中出现的”七柊“。 还有类似于”nanahira“本身应该不翻译,大模型强制翻译为中文”娜娜比拉“就非常出戏。
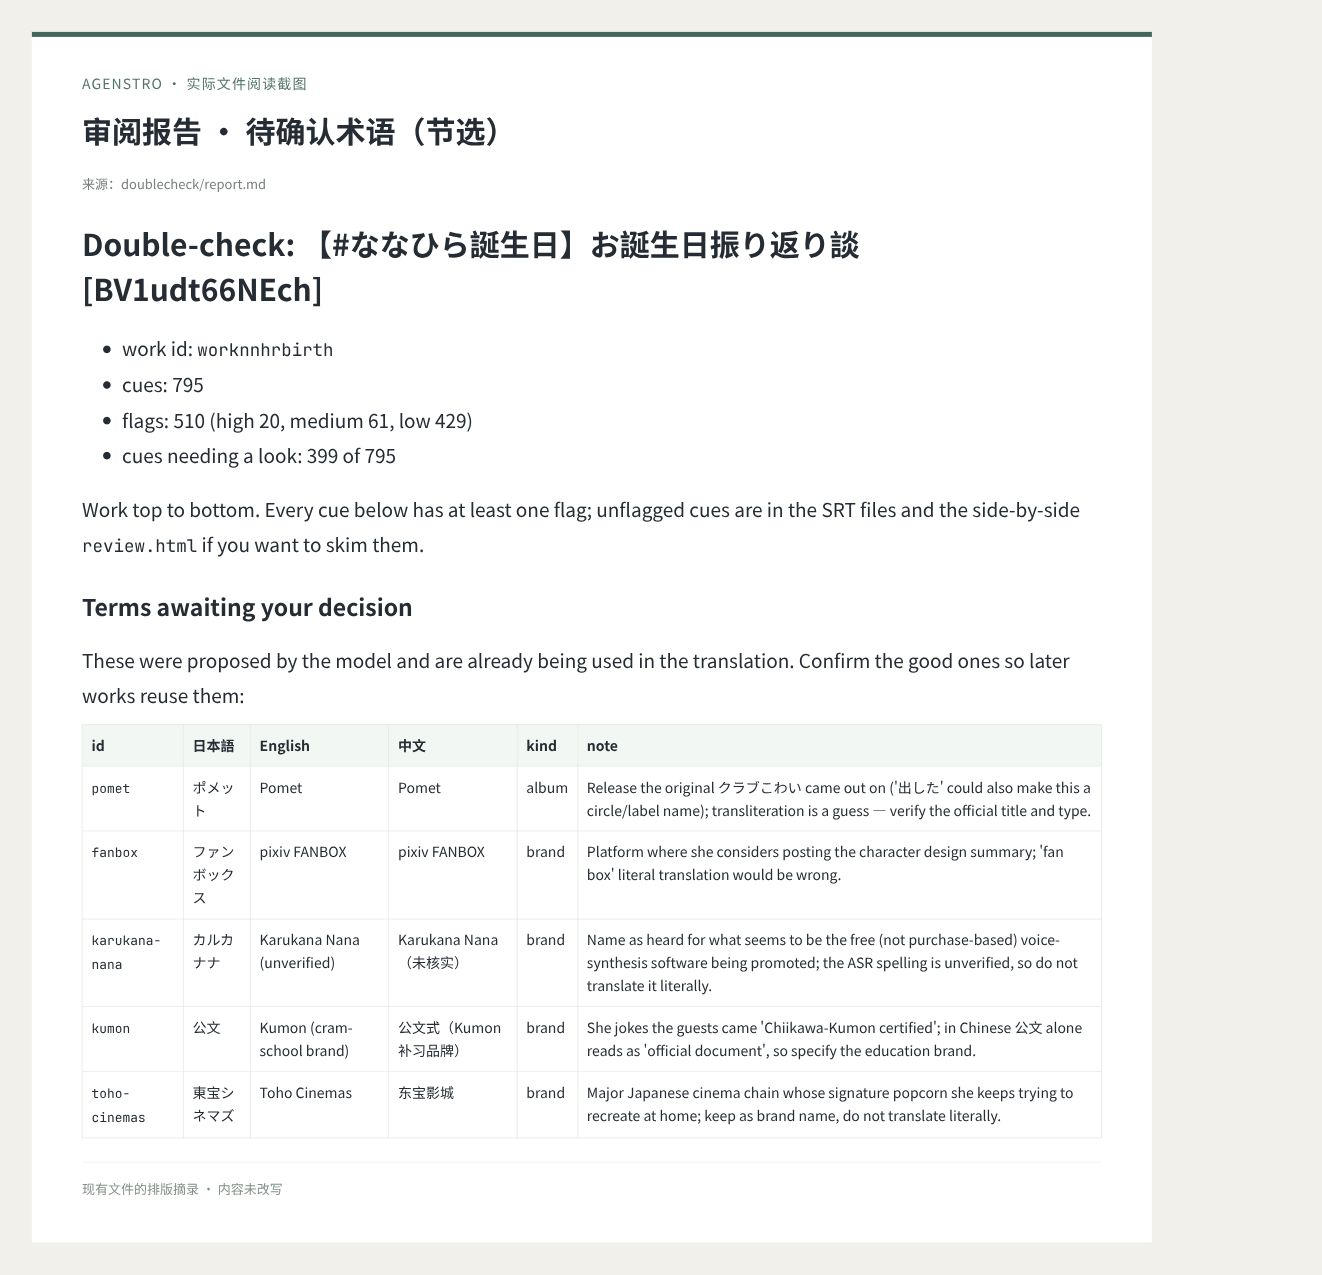
图 19:报告列出待确认的名字、品牌等条目,并保留模型说明中的不确定性。候选术语已经用于译文,仍需人工确认。
翻译任务接收一个窗口及其术语表:
translationTask :: Task (Window, [Term]) Text
translationTask = textTask "translate-window" translationPrompt
窗口以约 25 条字幕为目标,必要时扩展到完整语义单元,并附前后三条字幕作为上下文。当前 provider 使用 OpenCode 接入 GLM-5.3,最多五路并发。
翻译 prompt 强调的是:
生成自然、口语化的中文和英文,保留玩笑、语气和原文的不确定性,不补造内容。 参考完整句子和前后文,只输出当前目标字幕。 每个编号恰好出现一次,
zh和en都不能为空;遵守相关术语。 返回[{"i":编号,"zh":"中文","en":"English","note":"必要时说明歧义"}]。 不手工数长度,也不浏览工作区;需要的材料已经在请求里。
这里先保留回答的原始文本,再由程序解析,检查编号覆盖、空译文、假名残留、长度和阅读速度等问题。 需要修复时,只把有问题的字幕、原回答和错误原因回传;合格的部分先保存。
第三个坑是翻译结束的审阅问题 040_review.hs 另发请求,要求指出意思、语气、术语、梗和断句的问题。其结果与程序检查合并,生成日中英对照的审阅页面。
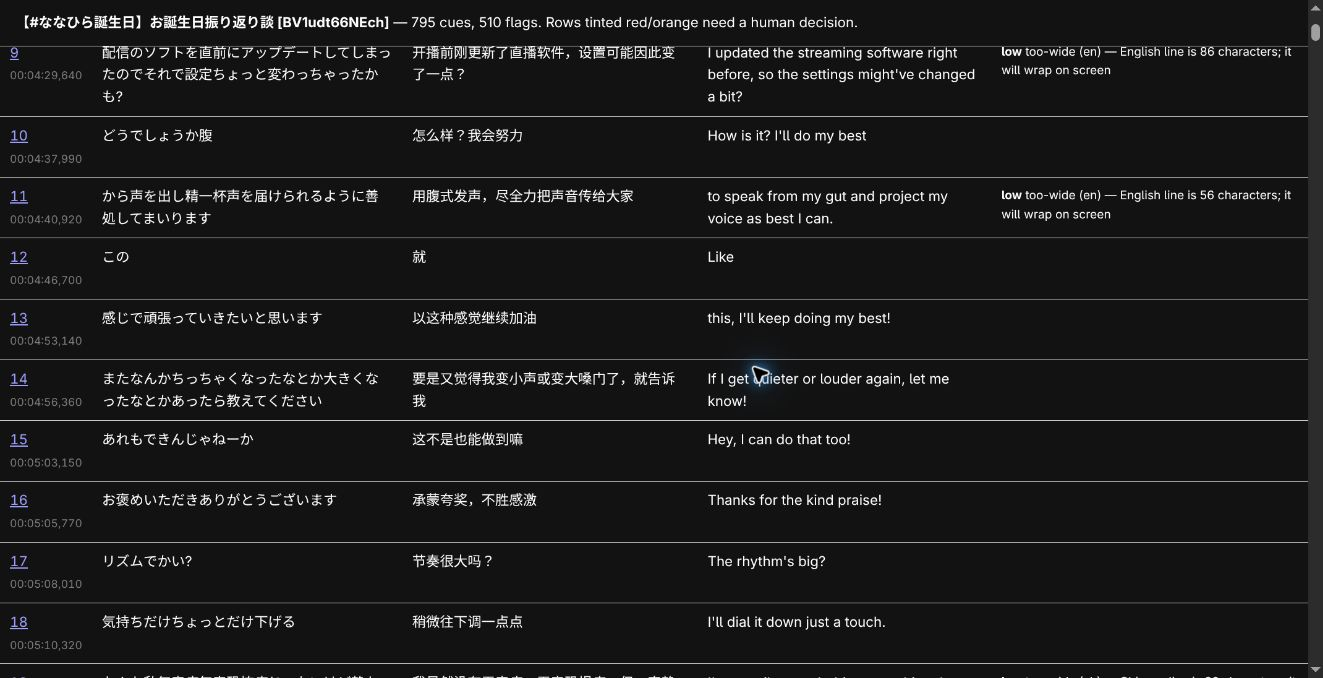
图 20:项目原有的 review.html,按字幕列出原文、两种译文和检查提示。
程序标记需要人判断。 例如中文里保留日文活动名会触发假名残留提示,可能是专名暂未确认,不能删除或强行翻译。
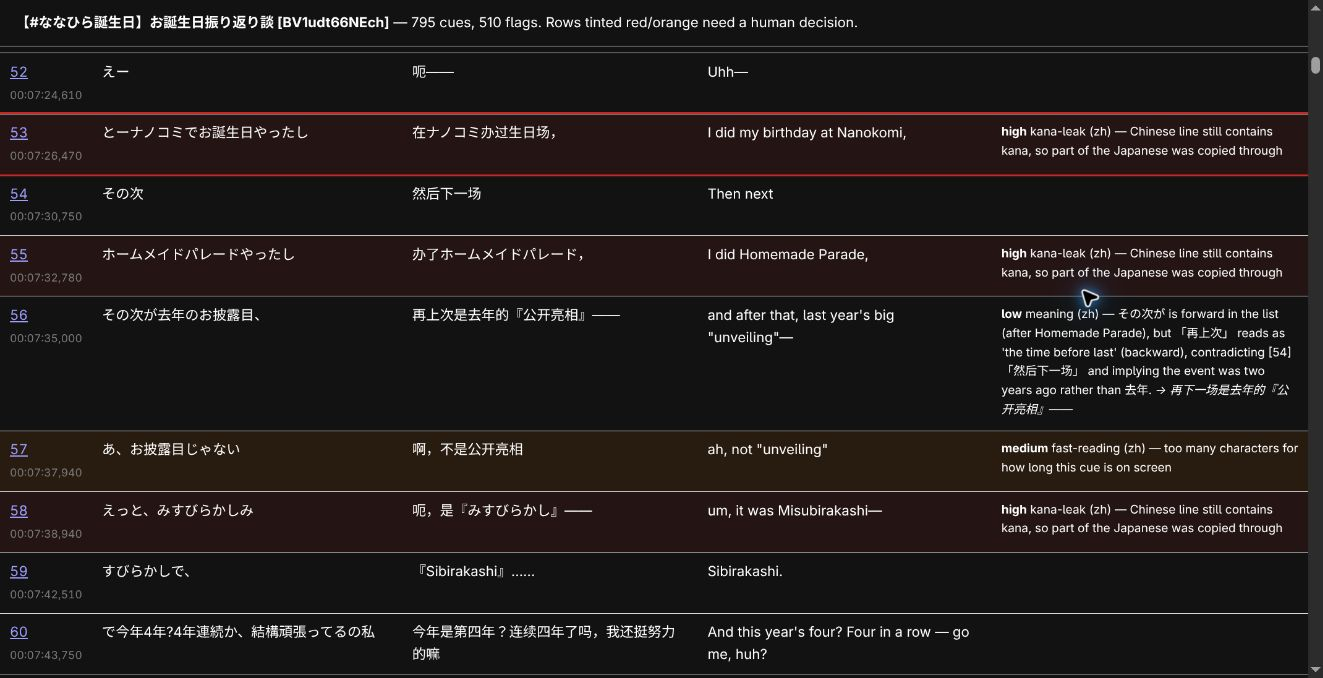
图 21:第 53 条附近的审阅结果。假名残留、阅读速度和模型提出的译义问题会分别保留。
最终形态
这次材料时长约 1 小时 14 分 58 秒,现有结果包含 795 条中文和英文字幕,34 个翻译窗口均已完成,并生成了审阅报告。
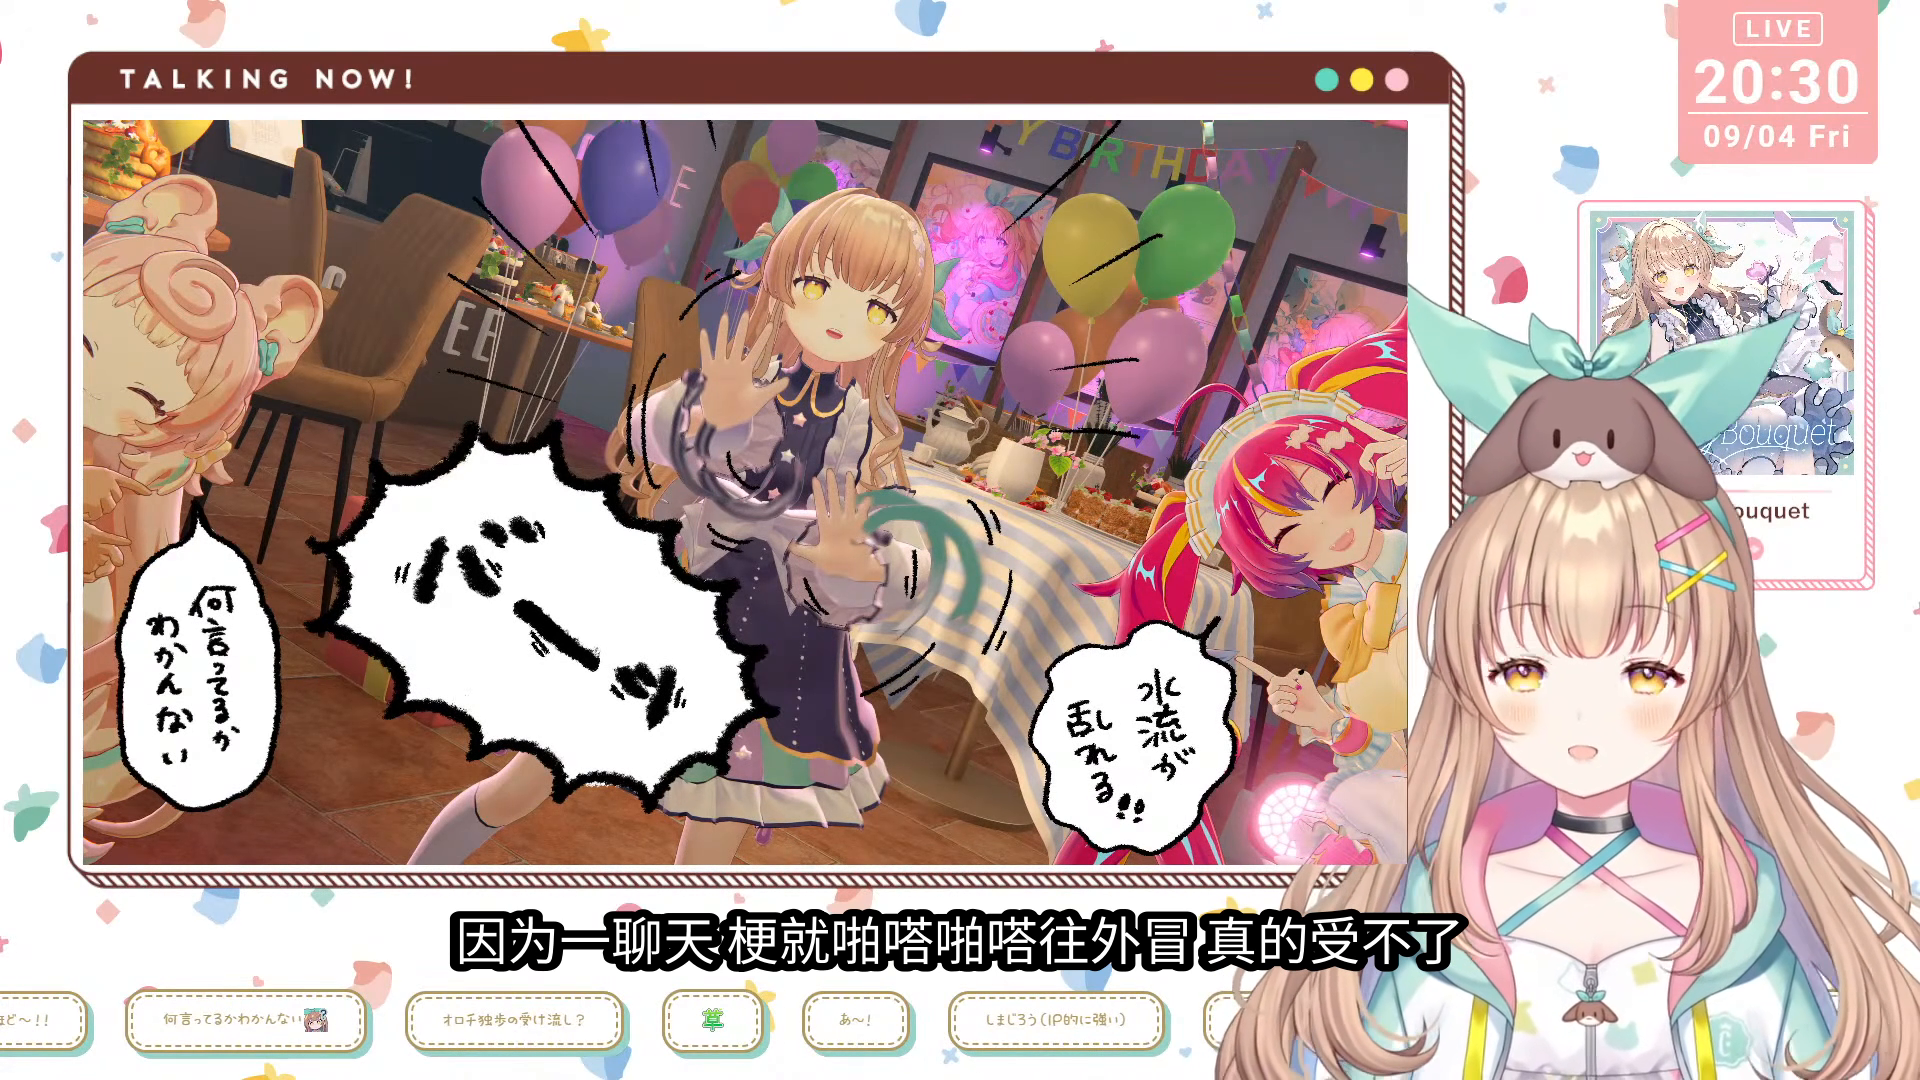
图 22:中文硬字幕成品在 00:28:19 的实际画面。
同一时间点的英文版会按照英文长度重新换行。
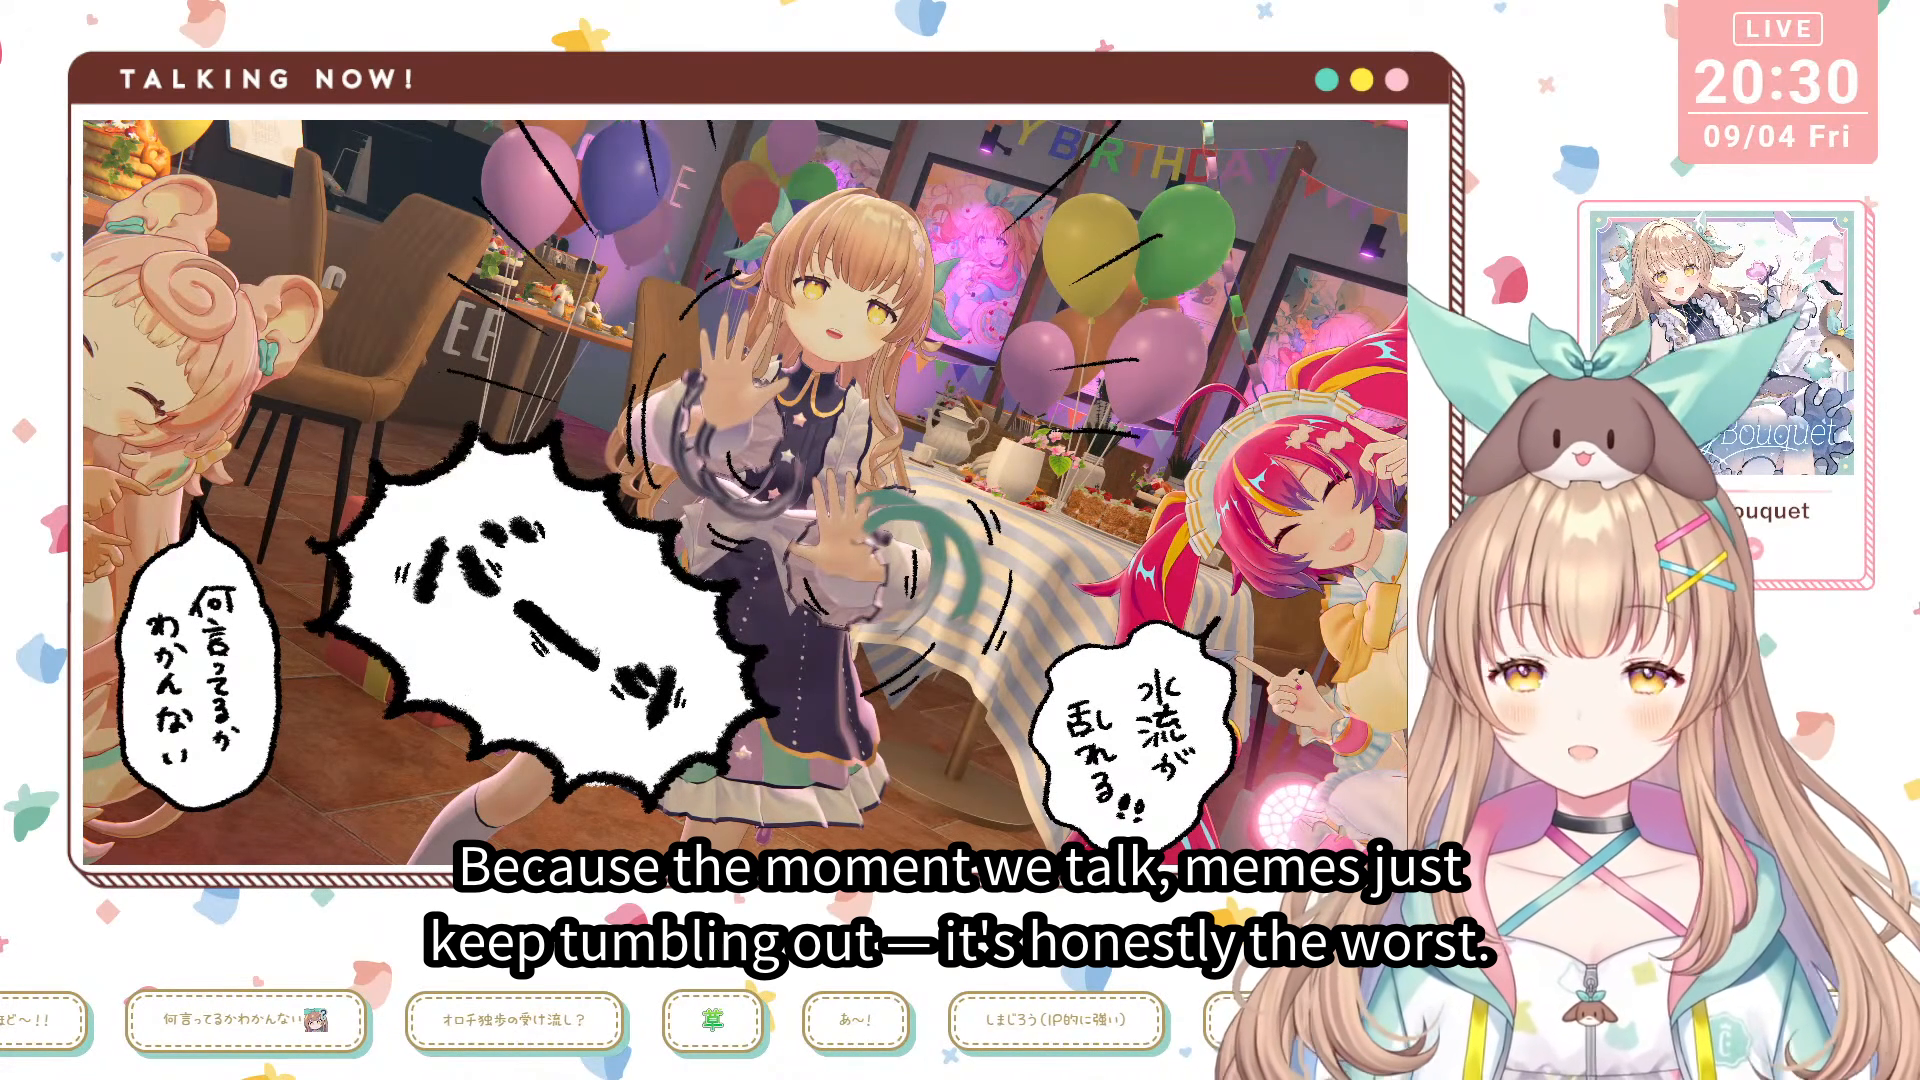
图 23:英文硬字幕成品在同一时间点的画面。
发布目录保留中文、英文两个 MP4 和软字幕 MKV,另有一份 1920 × 1080、约 192.9 MB 的中文压缩版,便于传输。
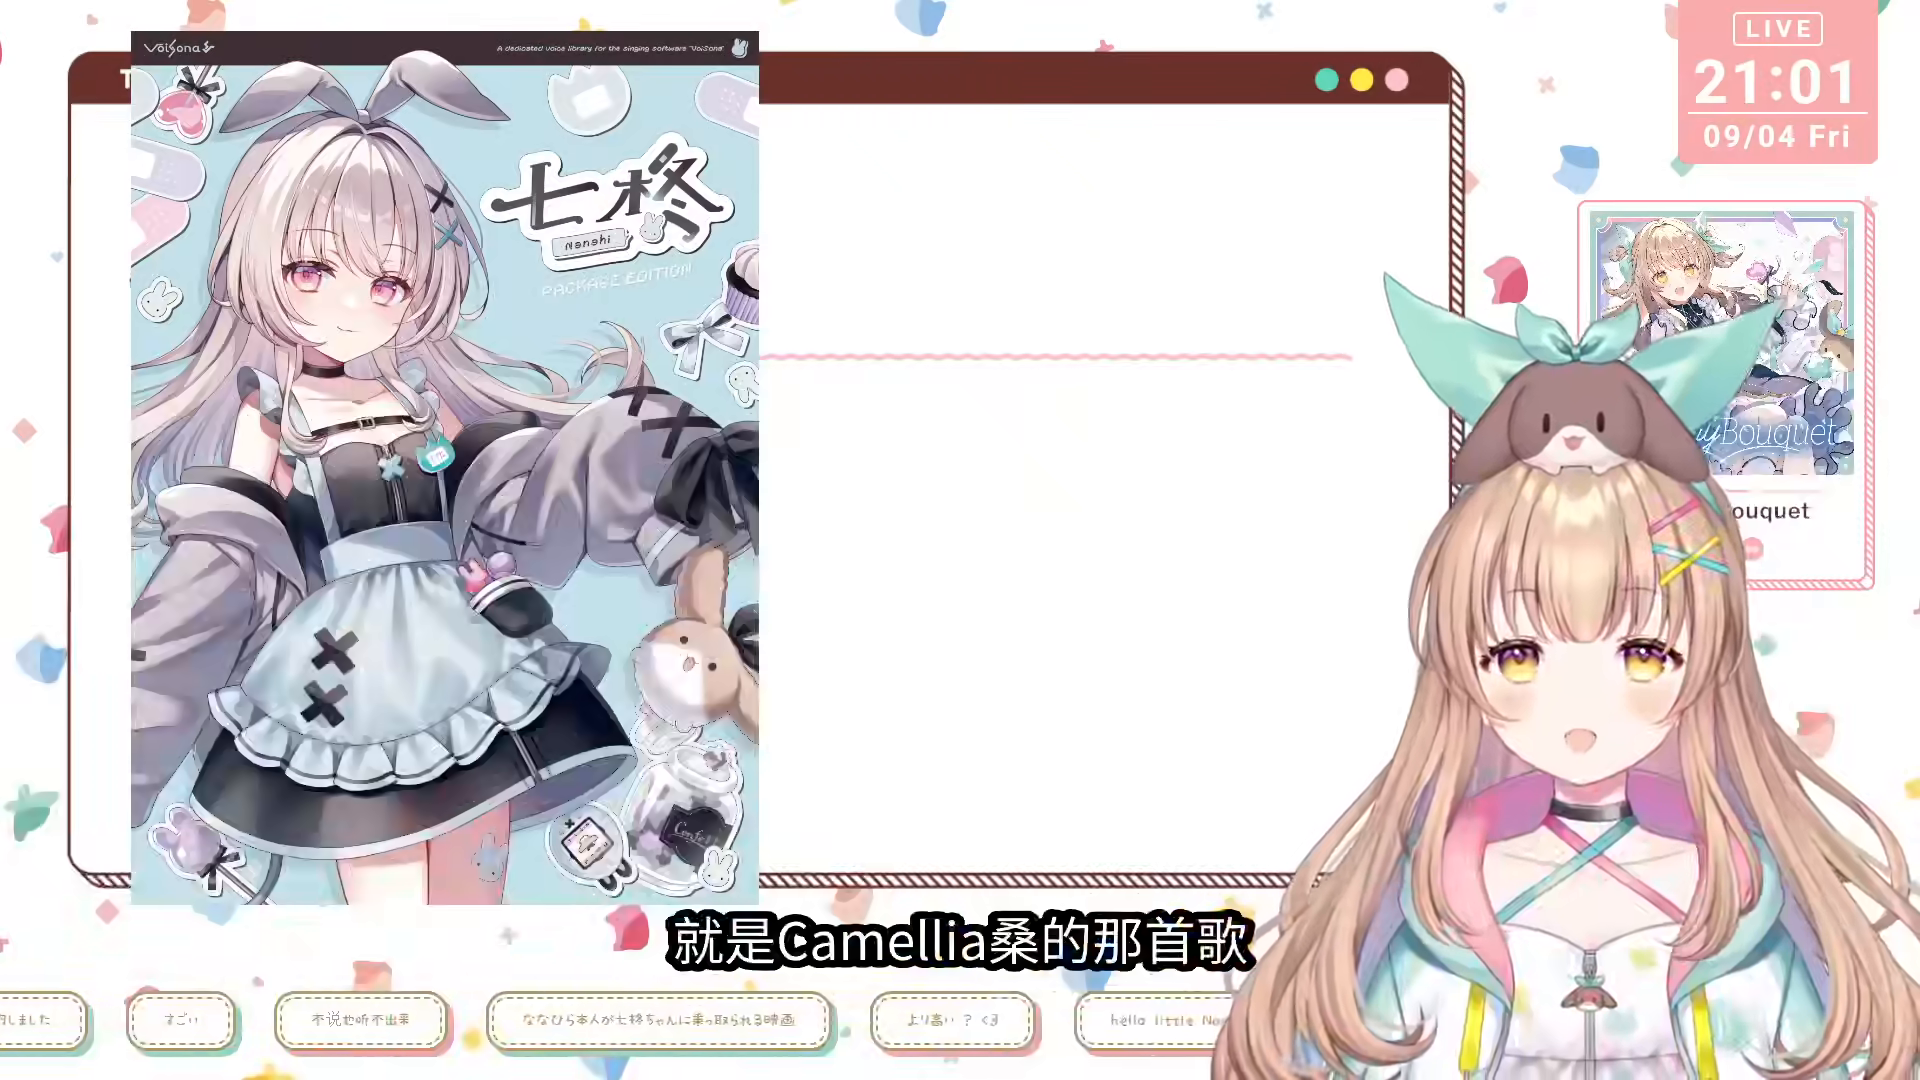
图 24:中文压缩版在 00:59:29 的实际画面。
审阅工作还没有全部结束。当前报告共有 510 条提示,涉及 399 条字幕,其中 high 20 条、medium 61 条、low 429 条;这些是待判断的提示,不等于 510 处已确认错误。术语库也还保留未确认候选。
因此,这里的“全自动”指从输入视频到字幕、报告和压制产物的流程已经走通。 专名识别、多人重叠说话和细微的时间轴偏差仍然会留下问题,产物已经可以播放和逐条审阅,最终发布前的语言判断仍需人工完成。
总结
笔者觉得这三轮任务存在的问题具有共性,集中在两个方面:
- 依赖人类识别任务流中的错误,并提出潜在的修改方向。
- 无人值守状态下模型行为存在越界风险。
这两个问题是互相关联的,首先是大模型在一些问题上依然缺乏判断力,对于任务3(nnhr直播烤肉),现在大模型是对此不是很熟悉的,我通过和某nnhr烤肉专家进行交流得到了正确的分词处理方法才成功。 那么这样一个本身就错误的流程会进一步导致agent loop可能执行出意外的结果。
这三个任务是我在还没有完善motivo时弄出来的。
显然即便对于这些流程尚不复杂、edge case还算明显的任务流都如此费劲,可以说llm workflow的根本瓶颈不再框架和llm本身,而是在于人本身对于问题的不了解。 也许更好的方向是在人推进和改进workflow的时候,Agenstro系统能够自动发现和补充使用者的知识漏洞。
这启发笔者关于正在开发的motivo分支的两个方面:
- 副作用plugin除了关于工作区文件状态,还可以针对性的新增对agent calling的行为监视。
例如,当agent calling出现以下行为的时候我们可以任务workflow本身存在缺陷、欠缺。
- 超时、超量推理(设置token阈值)
- 循环输出,这是典型的agent loop上下文过长导致的错误
- 多次compaction后性能蜕化
当然这个插件也是可以动态配置,这样在本身做一些研究型任务时不至于报错。
- 强化用户反馈
在1的基础上,每当workflow因为某些原因推进困难的时候,Agenstro能够提供一个接口去调查、研究、复盘、呈现,给用户以系统性的反馈信息。 这样就完成一个好的Human in the loop。
继续阅读
Agenstro 开发记录(二):架构设计
介绍 Agenstro 的 Clef、Tactus 与 Motivo 三层架构,以及工作流组合、provider 与副作用插件、运行监督和 human-in-the-loop 设计。
Agenstro 开发记录(一):项目动机
从早期工作流编排的局限出发,说明为何把 agent loop 视作原子化领域函数,并以函数式编程组织可组合、可持久化的工作流。